Anno 2026
Prova di Statistica 2026/05/25-1
Esercizio 1
Su un campione di \(200\) aziende con più di 1000 addetti dell’Emilia-Romagna è stato rilevato l’investimento effettuato negli ultimi 5 anni in intelligenza artificiale (espresso in milioni di euro). Di seguito è riportata la distribuzione delle frequenze percentuali:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(f_{j\%}\) |
|---|---|---|
| 0 | 1 | 65 |
| 1 | 3 | 25 |
| 3 | 5 | 5 |
| 5 | 10 | 5 |
| 100 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Disegnare l’istogramma di densità percentuale.
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 1 | 130 | 0.65 | 1 | 65.0 |
| 1 | 3 | 50 | 0.25 | 2 | 12.5 |
| 3 | 5 | 10 | 0.05 | 2 | 2.5 |
| 5 | 10 | 10 | 0.05 | 5 | 1.0 |
| 200 | 1.00 | 10 |
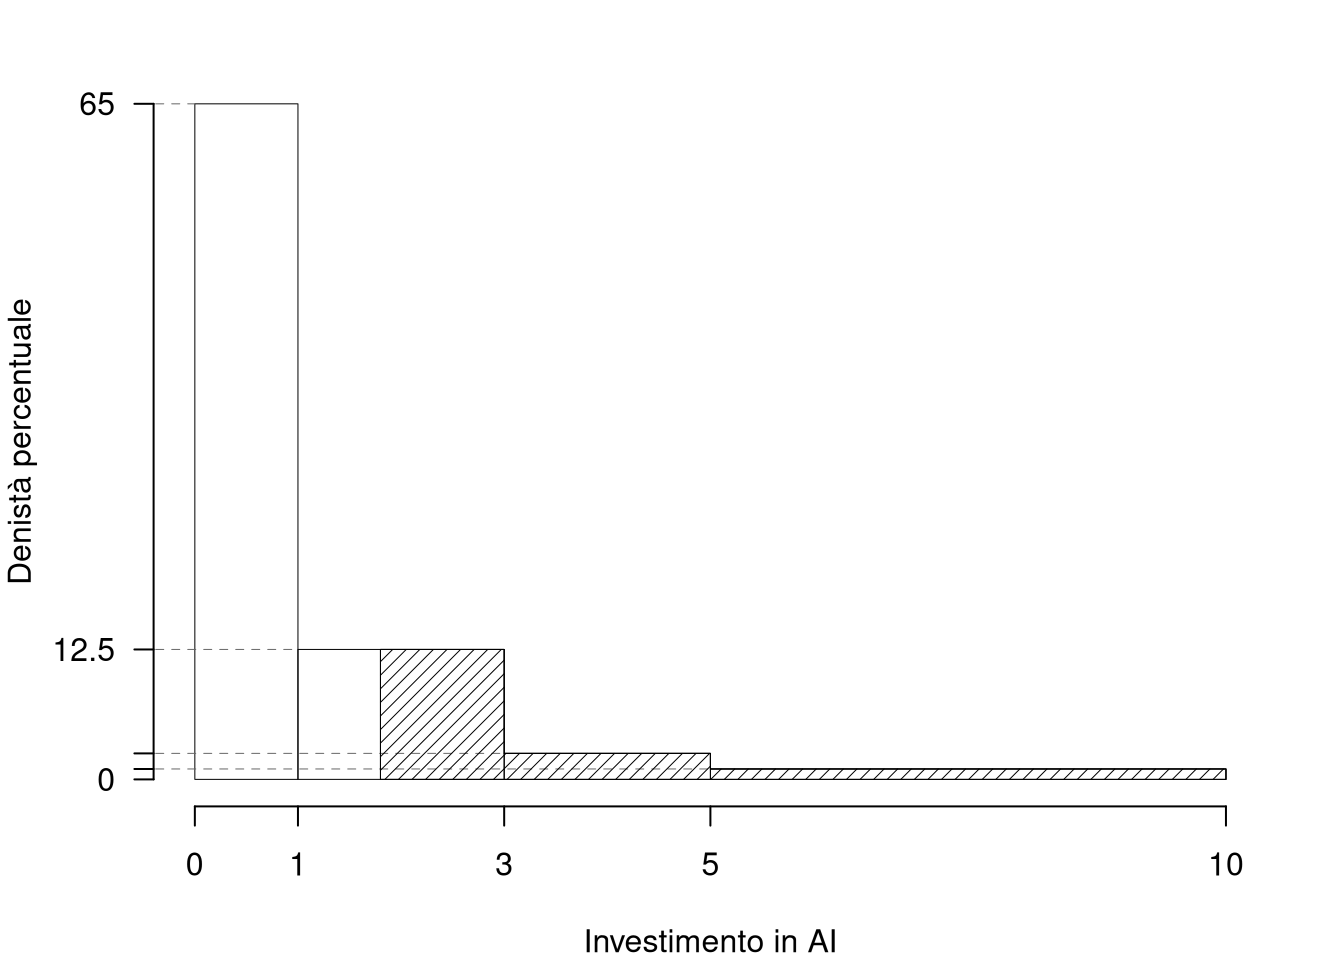
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero di aziende che hanno investito tra il 25-esimo e il 75-esimo percentile?
Per definizione \(\%(x_{0.25}<X<x_{0.75})=50\%\) e \(\#(x_{0.25}<X<x_{0.75})\approx0.5\times200 =100\)
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Che relazione dobbiamo aspettarci tra media, mediana e moda?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) L’investimento medio è pari a \(\bar x=1.4\), mentre la varianza è pari a \(\sigma^2=2.8\). Se ogni impresa aumentasse il proprio investimento del 5%, quanto varrebbero la media e la varianza dei dati così trasformati?
\[ \bar y= 1.47 ~~~~~~~~ \sigma^2_Y= 3.1035 \]
Esercizio 2
Un processo viene svolto da due agenti AI, \(A\) e \(B\). L’agente \(A\) commette un numero di allucinazioni che è distribuito secondo una Poisson di parametro 0.5, \(X_A \sim \text{Pois}(0.5)\), mentre per l’agente \(B\) il numero di allucinazioni è distribuito secondo una Poisson di parametro 0.3, \(X_B \sim \text{Pois}(0.3)\), \(X_A\) e \(X_B\) indipendenti. Il processo finale viene considerato inconsistente se gli agenti hanno commesso almeno una allucinazione (\(X_A+X_B\ge 1\)).
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che il processo sia inconsistente (\(X_A + X_B\ge 1\)).
\[ X_A + X_B \sim \text{Pois}(0.5+0.3) \] \[\begin{eqnarray*} P( X_A+X_B \geq 1 ) &=& 1-P( X_A+X_B < 1 ) \\ &=& 1-\left( \frac{ 0.8 ^{ 0 }}{ 0 !}e^{- 0.8 } \right)\\ &=& 1-( 0.4493 )\\ &=& 1- 0.4493 \\ &=& 0.5507 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) Calcolare la probabilità che \(X_A + X_B\ge 1\) per 3 processi consecutivi.
\[\begin{eqnarray*} P(X_A + X_B \ge 1) &=& 1 - P(X_A + X_B = 0) \\ &=& 0.5507\\ P(\text{3 volte}) &=& P(X_A + X_B \ge 1)^3\\ &=& 0.5507^3\\ &=& 0.167 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Sia \(Z\sim N(0,1)\) e \(Y\sim \text{Binom}(5,0.4)\), \(Z\) e \(Y\) indipendenti. Calcolare \(E(Z-Y)\) e \(V(Z-Y)\).
essendo
\[\begin{align} E(Z) &= 0; & \qquad V(Z) & = 1\\ E(Y) &=5\times 0.4 = 2; & \qquad V(Y) & = 5\times 0.4\times(1-0.4)=1.2\\ \end{align}\]
e quindi
\[\begin{eqnarray*} E(Z-Y) &=& 0-2\\ V(Z-Y) &=& 1+1.2\\ \end{eqnarray*}\]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\ne\emptyset\) e \(B\ne\emptyset\), tali che \(A\cap B = \emptyset\), \(A\) e \(B\) possono essere indipendenti? Perché?
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 pallina numerate con \(\fbox{0}\), 3 numerate con \(\fbox{1}\) e 1 numerate con \(\fbox{2}\). Si vince se esce \(\fbox{1}\) oppure \(\fbox{2}\) e si perde altrimenti. Si estrae 80 volte con reinserimento. Qual è la probabilità che la proporzione di vincite sia maggiore di 0.75?
Teorema del Limite Centrale (proporzione)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(X_i\sim\text{Ber}(\pi=0.8)\)\(,\forall i\), posto: \[ \hat\pi=\frac{S_n}n = \frac{X_1 + ... + X_n}n \] allora:\[\begin{eqnarray*} \hat\pi & \mathop{\sim}\limits_{a}& N(\pi,\pi(1-\pi)/n) \\ &\sim & N\left(0.8,\frac{0.8\cdot(1-0.8)}{80}\right) \\ &\sim & N(0.8,0.002) \end{eqnarray*}\]\[\begin{eqnarray*} P( \hat\pi > 0.75 ) &=& P\left( \frac { \hat\pi - \pi }{ \sqrt{\pi(1-\pi)/n} } > \frac { 0.75 - 0.8 }{\sqrt{ 0.002 }} \right) \\ &=& P\left( Z > -1.12 \right) \\ &=& 1-P(Z< -1.12 )\\ &=& 1-(1-\Phi( 1.12 )) \\ &=& 0.8686 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Si supponga di avere un modello \(\mathscr{M}(\theta;\psi)\), che dipende da due parametri: \(\theta\) che è un indicatore di centralità e \(\psi>0\) che è un indicatore di dispersione. Sia \(\hat \theta\) lo stimatore di massima verosimiglianza di \(\theta\). Sono noti \[\begin{eqnarray*} E(\hat\theta) &=& \frac{n-1}{n+1}\theta\\ V(\hat\theta) &=& \left(\frac{\psi}n\right)^{2/3} \end{eqnarray*}\] Dimostrare la consistenza di \(\hat \theta\).
osserviamo che \[ \operatorname{Bias}(\hat\theta) = E(\hat\theta)-\theta = \frac{n-1}{n+1}\theta-\theta = -\frac{2}{n+1}\theta \]
\[ \operatorname{MSE}(\hat\theta) = V(\hat\theta)+\operatorname{Bias}(\hat\theta)^2= \left(\frac{\psi}{n}\right)^{2} + \left(-\frac{2\theta}{n+1}\right)^2 \to 0. \]
Quindi \(\hat\theta\) è consistente.
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\theta_1\) e \(\hat\theta_2\) due stimatori corretti per \(\theta\), cosa significa dire che \(\hat\theta_1\) è più efficiente di \(\hat\theta_2\)?
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Definire gli errori di primo e secondo tipo di un test statistico e le relative probabilità.
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) In un sondaggio su 160 persone è stato chiesto il livello di utilizzo di strumenti di Intelligenza Artificiale (Basso, Medio, Alto) e l’opinione sul loro impatto nel mondo del lavoro (Favorevole, Contrario).
|
Livello di utilizzo
|
|||
|---|---|---|---|
| Basso | Medio | Alto | |
| Opinione | |||
| Favorevole | 30 | 10 | 35 |
| Contrario | 20 | 40 | 25 |
Eseguito il test del \(\chi^2\) per verificare l’indipendenza tra il livello di utilizzo degli strumenti di AI e l’opinione sul loro impatto nel mondo del lavoro, si ottiene un \(p_\text{value}=0.00002588\). Possiamo concludere che il livello di utilizzo e l’opinione sul loro impatto nel mondo del lavoro sono indipendenti? Perché?
Esercizio 5
In uno studio su (n=50) municipalità dell’Unione Europea, sono stati analizzati il tasso di disoccupazione giovanile (in percentuale, \(X\)) e la disponibilità di aree verdi urbane (in metri quadrati per abitante, \(Y\)).
Si osservano le seguenti statistiche: \(\sum_{i=1}^{50}x_i=498\), \(\sum_{i=1}^{50}y_i=1289.27\), \(\sum_{i=1}^{50}x_i^2=5025.18\), \(\sum_{i=1}^{50}y_i^2=36923.54\) e \(\sum_{i=1}^{50}x_iy_i=12393.43\).
5.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per la regione \(R\) si è osservato \(x_R=10.6\) e \(y_R=24.48\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per la regione \(R\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 498 = 9.96 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 1289.27 = 25.79 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5025 - 9.96 ^2= 1.302 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 36924 - 25.7854 ^2= 73.58 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 12393 - 9.96 \cdot 25.7854 = -8.954 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ -8.954 }{ 1.302 } = -6.877 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 25.79 - (-6.8771) \times 9.96 = 94.28 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 94.28 + (-6.8771) \times 10.6 = 21.38 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 24.48 - 21.3841 = 3.098 \end{eqnarray*}\]
5.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ -8.954 }{ 1.141 \times 8.578 }= -0.9148 \\ r^2&=& 0.8368 > 0.75 \end{eqnarray*}\]
Il modello si adatta bene ai dati.
Il modello spiega il \(83.68\%\) della variabilità totale della \(Y\).
5.c (Punti 13/103 \(\rightarrow\) 3.9/31) Testare l’ipotesi che \(\beta_1 = -5\) contro l’alternativa che sia diverso.
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \beta_1 = \beta_{1;H_0}=-5.5 \\ H_1: \beta_1 \neq \beta_{1;H_0}=-5.5 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(T\) Test su un coefficiente di regressione: \(\Rightarrow\) t-Test.
\[\begin{eqnarray*} \hat{\sigma_\varepsilon}^2&=&(1-r^2)\hat\sigma_Y^2\\ &=& (1- 0.8369 )\times 73.58 \\ &=& 12.01 \\ S_\varepsilon^2 &=& \frac{n} {n-2} \hat{\sigma_\varepsilon}^2\\ &=& \frac{ 50 } { 50 -2} \hat{\sigma_\varepsilon}^2 \\ &=& \frac{ 50 } { 50 -2} \times 12.01 = 12.51 \end{eqnarray*}\]
E quindi\[\begin{eqnarray*} V(\hat\beta_{1}) &=& \frac{\sigma_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ \widehat{V(\hat\beta_{1})} &=& \frac{S_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ &=& \frac{ 12.51 } { 50 \times 1.302 } = 0.1921 \\ \widehat{SE(\hat\beta_{1})} &=& \sqrt{ 0.1921 }\\ &=& 0.4383 \end{eqnarray*}\]
\[\begin{eqnarray*} \frac{\hat\beta_{ 1 } - \beta_{ 1 ;H_0}} {\widehat{SE(\hat\beta_{ 1 })}}&\sim&t_{n-2}\\ t_{\text{obs}} &=& \frac{ ( -6.877 - -5.5 )} { 0.4383 } = -3.142 \, . \end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Siccome \(H_1\) è bilaterale, considereremo \(\alpha/2\), anziché \(\alpha\)
\(\alpha=0.1, 0.05, 0.01, 0.001\) e quindi \(\alpha/2=0.05, 0.025, 0.005, 0.0005\)
I valori critici sono
\(t_{50-2;0.05}=1.6772\); \(t_{50-2;0.025}=2.0106\); \(t_{50-2;0.005}=2.6822\); \(t_{50-2;0.0005}=3.5051\)
Siccome \(2.6822<|t_\text{obs}|=3.1416<3.5051\), quindi rifiuto \(H_0\) all’1%,
\(0.001<p_\text{value}<0.01\), molto significativo \(\fbox{**}\).
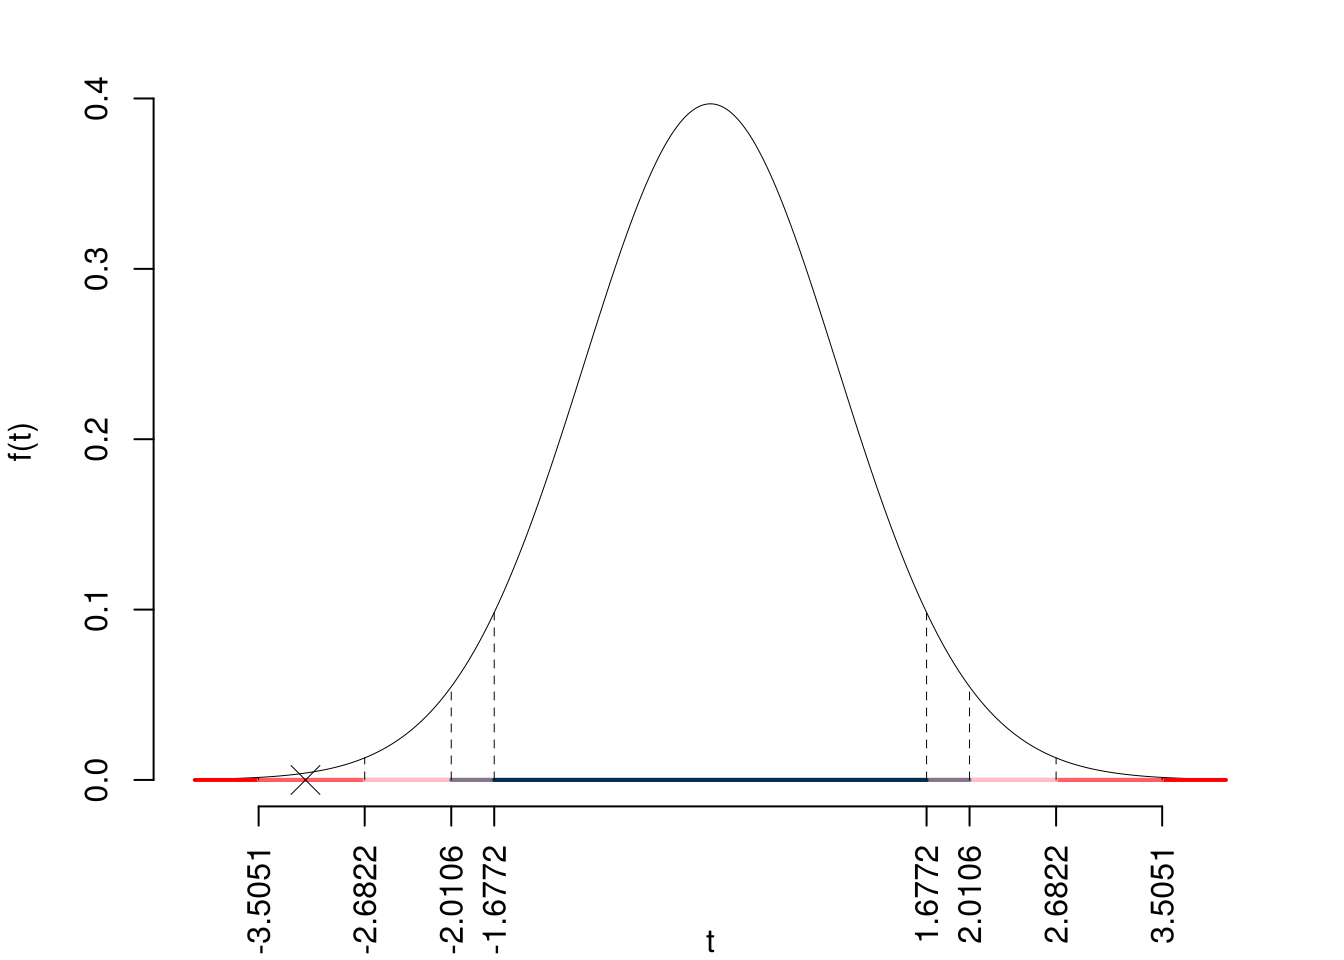
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(|T_{50-2}|>|-3.14|)=2P(T_{50-2}>3.14)=0.002877 \]
Attenzione il calcolo del \(p_\text{value}\) con la \(T\) è puramente illustrativo e non può essere riprodotto senza una calcolatrice statistica adeguata.\[ 0.001 < p_\text{value}= 0.002877 \leq 0.01 \]
5.d (Punti 2/103 \(\rightarrow\) 0.6/31) Perché una previsione per \(x=10\) è più precisa di una previsione per \(x=100\)?
5.e (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione \(\hat\beta_1 =0\) quanto vale \(r\)?
5.f (Punti 2/103 \(\rightarrow\) 0.6/31) Cosa significa dire che \(r^2\) è invariante ai cambiamenti di scala?
No. Il fatto che \(r_{XY}=0\) indica solo assenza di relazione lineare tra \(X\) e \(Y\). Potrebbero comunque esistere relazioni di altra natura, ad esempio una relazione curvilinea (quadratica, esponenziale, ecc.), non rilevata dal coefficiente di correlazione lineare.
Prova di Statistica 2026/05/25-2
Esercizio 1
Su un campione di \(150\) aziende con più di 1000 addetti dell’Emilia-Romagna è stato rilevato l’investimento effettuato negli ultimi 5 anni in intelligenza artificale (espresso in milioni di euro). Di seguito è riportata la distribuzione delle densità percentuali:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(h_j\) |
|---|---|---|
| 0 | 1 | 30.0 |
| 1 | 2 | 40.0 |
| 2 | 6 | 5.0 |
| 6 | 10 | 2.5 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare il valore approssimativo della mediana
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 1 | 45 | 0.3 | 1 | 30.0 |
| 1 | 2 | 60 | 0.4 | 1 | 40.0 |
| 2 | 6 | 30 | 0.2 | 4 | 5.0 |
| 6 | 10 | 15 | 0.1 | 4 | 2.5 |
| 150 | 1.0 | 10 |
\[\begin{eqnarray*}
p &=& 0.5 , \text{essendo }F_{ 2 }= 0.7 > 0.5 \Rightarrow j_{ 0.5 }= 2 \\
x_{ 0.5 } &=& x_{\text{inf}; 2 } + \frac{ { 0.5 } - F_{ 1 }} {f_{ 2 }} \cdot b_{ 2 } \\
&=& 1 + \frac {{ 0.5 } - 0.3 } { 0.4 } \cdot 1 \\
&=& 1.5
\end{eqnarray*}\]
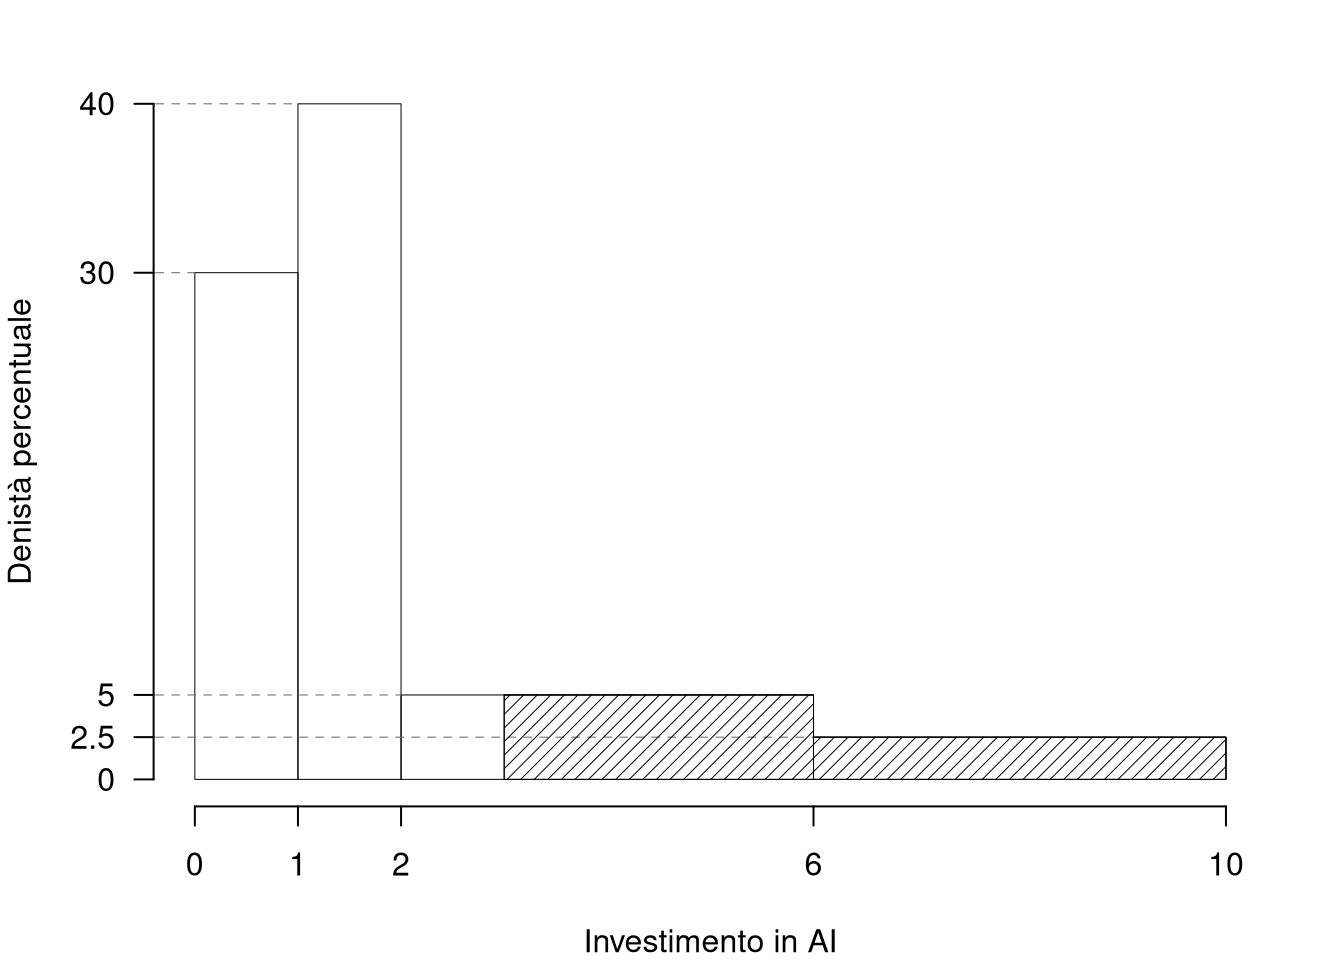
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero approssimativo di aziende hanno investito più di 3 milioni di euro?
\[\begin{eqnarray*} \%(X> 3 ) &=& ( 6 - 3 )\times h_{ 3 }+ f_{ 4 }\times 100 \\ &=& ( 3 )\times 5 + ( 0.1 )\times 100 \\ &=& 0.25 \times(100)\\ \#(X> 3 ) &\approx& 38 \end{eqnarray*}\]
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Che relazione dobbiamo aspettarci tra media, mediana e moda?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) L’investimento medio è pari a \(\bar x=2.4\), mentre la varianza è pari a \(\sigma^2=5.1\). Se ogni impresa aumentasse il proprio investimento di un milione di euro, quanto varrebbero la media e la varianza dei dati così trasformati?
\[ \bar y= 3.4 ~~~~~~~~ \sigma^2_Y= 5.1 \]
Esercizio 2
Un processo viene svolto da due agenti AI in sequenza, prima \(A\) e poi \(B\). Il tempo impiegato dall’agente \(A\), misurato in secondi, è distribuito secondo una Normale con media 8 e varianza 1, \(X_A \sim N(8,1)\), mentre il tempo impiegato dall’agente \(B\) è distribuito secondo una Normale con media 10 e varianza 3, \(X_B \sim N(10,3)\), con \(X_A\) e \(X_B\) indipendenti. Il processo finale viene considerato troppo lento se il tempo complessivo supera 22 secondi.
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che il processo sia troppo lento (\(P(X_A+X_B>22)\)).
\[ X=X_A + X_B \sim N(8+10,1+3) \] \[\begin{eqnarray*} P( X > 22 ) &=& P\left( \frac { X - \mu }{ \sigma } > \frac { 22 - 18 }{\sqrt{ 4 }} \right) \\ &=& P\left( Z > 2 \right) \\ &=& 1-P(Z< 2 )\\ &=& 1-\Phi( 2 ) \\ &=& 0.0228 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) Calcolare \(P(X_A + X_B\le 23|X_A + X_B> 22)\).
\[ X=X_A + X_B \sim N(8+10,1+3) \]
\[\begin{eqnarray*} P(X\le 23|X> 22) &=& \frac{P(X\le 23\cap X> 22)}{P(X> 22)}\\ &=& \frac{P(22<X\le 23)}{P(X> 22)}\\ &=& \frac{0.9938-0.9772}{0.0228}\\ &=& 0.727 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(X_1\sim \text{Ber}(0.5)\), \(X_2\sim \text{Ber}(0.5)\) e \(X_3\sim \text{Ber}(0.5)\), 3 Bernoulli indipendenti. Come si distribuisce \(X=X_1+X_2+X_3\)?
\[ X_1+X_2+X_3 \sim \text{Binom}(3,0.5) \]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\ne\emptyset\) e \(B\ne\emptyset\), tali che \(P(B|A)=0.5\), \(P(B|\bar A)=0.4\) e \(P(A)=0.3\), calcolare \(P(B)\).
\[\begin{eqnarray*} P(B) &=& P(B|A)P(A)+P(B|bar A)P(\bar A)\\ &=& 0.5\times 0.3+ 0.4\times(1-0.3)\\ &=& 0.43 \end{eqnarray*}\]
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 palline numerate con \(\fbox{0}\), 3 numerate con \(\fbox{1}\) e 1 numerate con \(\fbox{2}\). Si vince se esce \(\fbox{1}\) oppure \(\fbox{2}\) e si perde altrimenti. Si estrae 80 volte con reinserimento. Qual è la probabilità di vincere meno di 60 volte?
Teorema del Limite Centrale (somma di Bernoulli)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(X_i\sim\text{Ber}(\pi=0.8)\)\(,\forall i\), posto: \[ S_n = X_1 + ... + X_n \] allora:\[\begin{eqnarray*} S_n & \mathop{\sim}\limits_{a}& N(n\pi,n\pi(1-\pi)) \\ &\sim & N(80\cdot0.8,80\cdot0.8\cdot(1-0.8)) \\ &\sim & N(64,12.8) \end{eqnarray*}\]\[\begin{eqnarray*} P( S_n < 60 ) &=& P\left( \frac { S_n - n\pi }{ \sqrt{n\pi(1-\pi)} } < \frac { 60 - 64 }{\sqrt{ 12.8 }} \right) \\ &=& P\left( Z < -1.12 \right) \\ &=& 1-\Phi( 1.12 ) \\ &=& 0.1314 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Si supponga di avere un modello \(\mathscr{M}(\theta;\psi)\), che dipende da due parametri: \(\theta\) che è un indicatore di centralità e \(\psi>0\) che è un indicatore di dispersione. Sia \(\hat \theta\) lo stimatore di massima verosimiglianza di \(\theta\). Sono noti \[\begin{eqnarray*} E(\hat\theta) &=& \theta+\frac 1 n\\ V(\hat\theta) &=& \frac{\psi}n \end{eqnarray*}\] Dimostrare la consistenza di \(\hat \theta\).
Si ha
\[ \operatorname{Bias}(\hat\theta) = E(\hat\theta)-\theta = \theta+\frac1n-\theta = \frac1n. \]
Quindi
\[ \operatorname{Bias}(\hat\theta)^2 = \frac1{n^2}. \]
Inoltre
\[ V(\hat\theta)=\frac{\psi}{n}. \]
L’errore quadratico medio è quindi
\[ MSE(\hat\theta) = V(\hat\theta)+\operatorname{Bias}(\hat\theta)^2 = \frac{\psi}{n}+\frac1{n^2}. \]
\[ \lim_{n\to\infty}\operatorname{MSE}(\hat\theta) = \lim_{n\to\infty} \left( \frac{\psi}{n}+\frac1{n^2} \right) = 0. \]
Quindi \(\hat\theta\) è consistente in media quadratica, e dunque consistente.
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\theta_1\) e \(\hat\theta_2\) due stimatori non corretti per \(\theta\), cosa significa dire che \(\hat\theta_1\) è più efficiente di \(\hat\theta_2\)?
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Definire la significatività e la potenza di un test.
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) In un sondaggio su 180 lavoratori è stato chiesto il livello di formazione ricevuta sull’uso degli strumenti di Intelligenza Artificiale (Basso, Medio, Alto) e la valutazione della propria preparazione rispetto ai cambiamenti tecnologici nel lavoro (Adeguata, Insufficiente).
|
Livello di formazione
|
|||
|---|---|---|---|
| Basso | Medio | Alto | |
| Preparazione | |||
| Adeguata | 18 | 32 | 45 |
| Insufficiente | 42 | 28 | 15 |
Eseguito il test del \(\chi^2\) per verificare l’indipendenza tra il livello di formazione sugli strumenti di AI e la valutazione della preparazione rispetto ai cambiamenti tecnologici, si ottiene un \(p_\text{value}=0.000005065\). Possiamo concludere che le due variabili sono indipendenti? Perché?
No, non sono indipendenti perché \(p_\text{value}=0.000005065<0.001\).
Esercizio 5
In uno studio su (n=50) municipalità dell’Unione Europea, sono stati analizzati il tasso di disoccupazione giovanile (in percentuale, \(X\)) e il numero di posti a sedere in teatro e cinema per abitante (\(Y\)).
Si osservano le seguenti statistiche: \(\sum_{i=1}^{50}x_i=500.4\), \(\sum_{i=1}^{50}y_i=114.68\), \(\sum_{i=1}^{50}x_i^2=5047.02\), \(\sum_{i=1}^{50}y_i^2=263.79\) e \(\sum_{i=1}^{50}x_iy_i=1151.3\).
5.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per la regione \(R\) si è osservato \(x_R=10.5\) e \(y_R=2.19\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per la regione \(R\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 500.4 = 10.01 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 114.68 = 2.294 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5047 - 10.008 ^2= 0.7803 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 263.8 - 2.2936 ^2= 0.0152 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 1151 - 10.008 \cdot 2.2936 = 0.07166 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ 0.07166 }{ 0.7803 } = 0.09183 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 2.294 - 0.0918 \times 10.008 = 1.375 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 1.375 + 0.0918 \times 10.5 = 2.339 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 2.192 - 2.3388 = -0.1471 \end{eqnarray*}\]
5.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ 0.07166 }{ 0.8834 \times 0.1233 }= 0.658 \\ r^2&=& 0.4329 < 0.75 \end{eqnarray*}\]
Il modello non si adatta bene ai dati.
Il modello spiega il \(43.29\%\) della variabilità totale della \(Y\).
5.c (Punti 13/103 \(\rightarrow\) 3.9/31) Testare l’ipotesi che \(\beta_1 = 0.15\) contro l’alternativa che sia diverso.
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \beta_1 = \beta_{1;H_0}=0.15 \\ H_1: \beta_1 \neq \beta_{1;H_0}=0.15 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(T\) Test su un coefficiente di regressione: \(\Rightarrow\) t-Test.
\[\begin{eqnarray*} \hat{\sigma_\varepsilon}^2&=&(1-r^2)\hat\sigma_Y^2\\ &=& (1- 0.433 )\times 0.0152 \\ &=& 0.0086 \\ S_\varepsilon^2 &=& \frac{n} {n-2} \hat{\sigma_\varepsilon}^2\\ &=& \frac{ 50 } { 50 -2} \hat{\sigma_\varepsilon}^2 \\ &=& \frac{ 50 } { 50 -2} \times 0.0086 = 0.009 \end{eqnarray*}\]
E quindi\[\begin{eqnarray*} V(\hat\beta_{1}) &=& \frac{\sigma_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ \widehat{V(\hat\beta_{1})} &=& \frac{S_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ &=& \frac{ 0.009 } { 50 \times 0.7803 } = 0.0002 \\ \widehat{SE(\hat\beta_{1})} &=& \sqrt{ 0.0002 }\\ &=& 0.01414 \end{eqnarray*}\]
\[\begin{eqnarray*} \frac{\hat\beta_{ 1 } - \beta_{ 1 ;H_0}} {\widehat{SE(\hat\beta_{ 1 })}}&\sim&t_{n-2}\\ t_{\text{obs}} &=& \frac{ ( 0.09183 - 0.15 )} { 0.01517 } = -3.835 \, . \end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Siccome \(H_1\) è bilaterale, considereremo \(\alpha/2\), anziché \(\alpha\)
\(\alpha=0.1, 0.05, 0.01, 0.001\) e quindi \(\alpha/2=0.05, 0.025, 0.005, 0.0005\)
I valori critici sono
\(t_{50-2;0.05}=1.6772\); \(t_{50-2;0.025}=2.0106\); \(t_{50-2;0.005}=2.6822\); \(t_{50-2;0.0005}=3.5051\)
Siccome \(|t_\text{obs}|=3.8349>3.5051\), quindi rifiuto \(H_0\) sotto all’1‰,
\(p_\text{value}<0.001\), estremamente significativo \(\fbox{***}\).
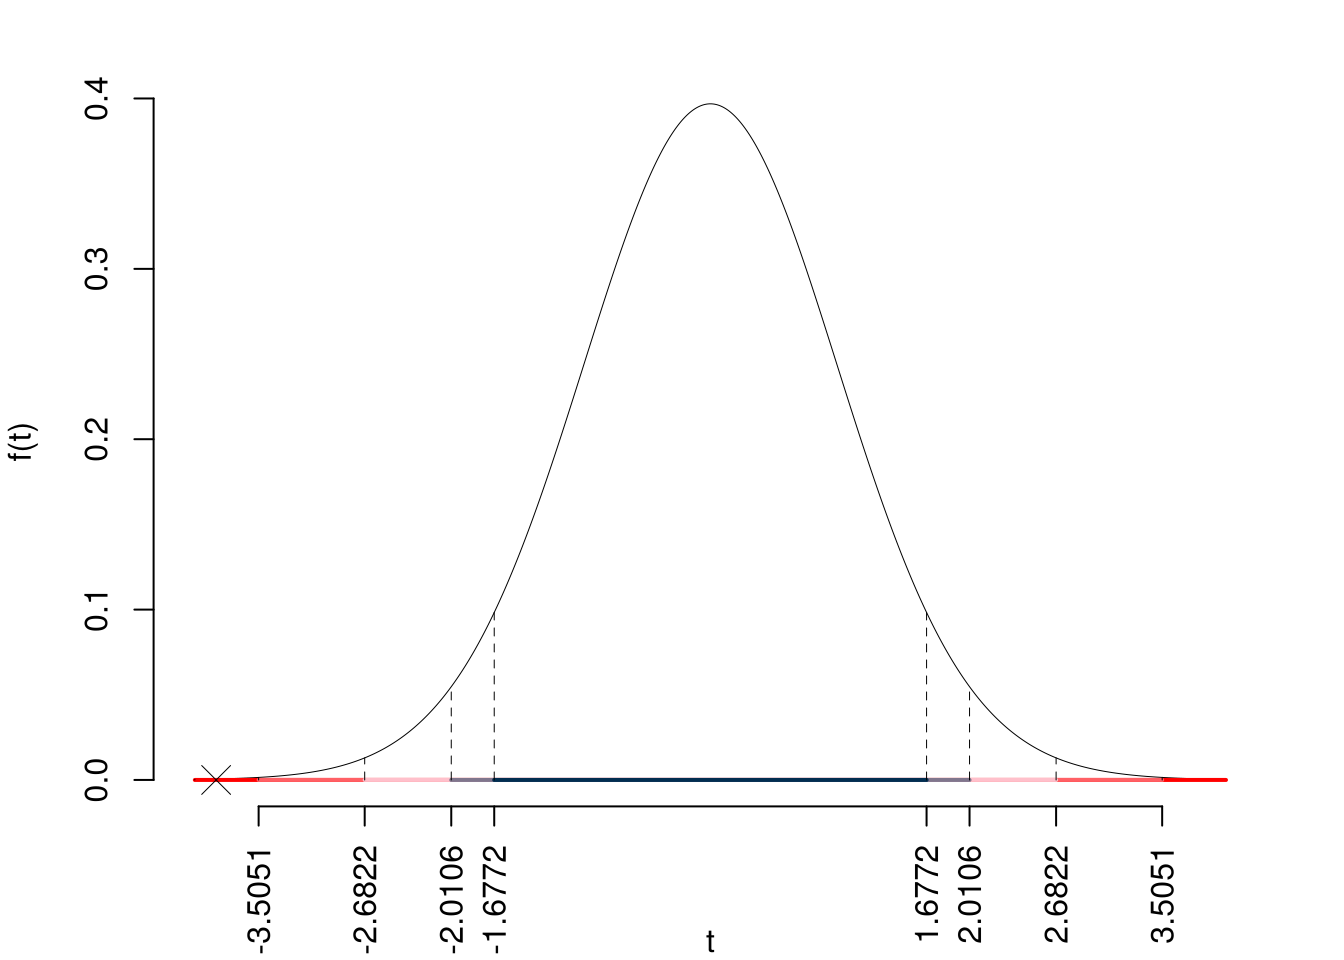
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(|T_{50-2}|>|-3.83|)=2P(T_{50-2}>3.83)=0.000366 \]
Attenzione il calcolo del \(p_\text{value}\) con la \(T\) è puramente illustrativo e non può essere riprodotto senza una calcolatrice statistica adeguata.\[ 0 < p_\text{value}= 0.000366 \leq 0.001 \]
5.d (Punti 2/103 \(\rightarrow\) 0.6/31) Che differenza c’è tra interpolazione ed estrapolazione?
5.e (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione \(\hat\beta_1 <0\) che segno avrà \(r\)?
5.f (Punti 2/103 \(\rightarrow\) 0.6/31) Cosa significa quando \(r=-1\)?
Prova di Statistica 2026/05/25-3
Esercizio 1
Su un campione di \(200\) aziende con più di 1000 addetti dell’Emilia-Romagna è stato rilevato l’investimento effettuato negli ultimi 5 anni in intelligenza artificale (espresso in milioni di euro). Di seguito è riportata la distribuzione delle frequenze cumulate:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(F_j\) |
|---|---|---|
| 0.0 | 1.5 | 0.30 |
| 1.5 | 3.0 | 0.80 |
| 3.0 | 6.0 | 0.95 |
| 6.0 | 10.0 | 1.00 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Disegnare l’istogramma di densità percentuale.
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0.0 | 1.5 | 60 | 0.30 | 1.5 | 20.00 |
| 1.5 | 3.0 | 100 | 0.50 | 1.5 | 33.33 |
| 3.0 | 6.0 | 30 | 0.15 | 3.0 | 5.00 |
| 6.0 | 10.0 | 10 | 0.05 | 4.0 | 1.25 |
| 200 | 1.00 | 10.0 |
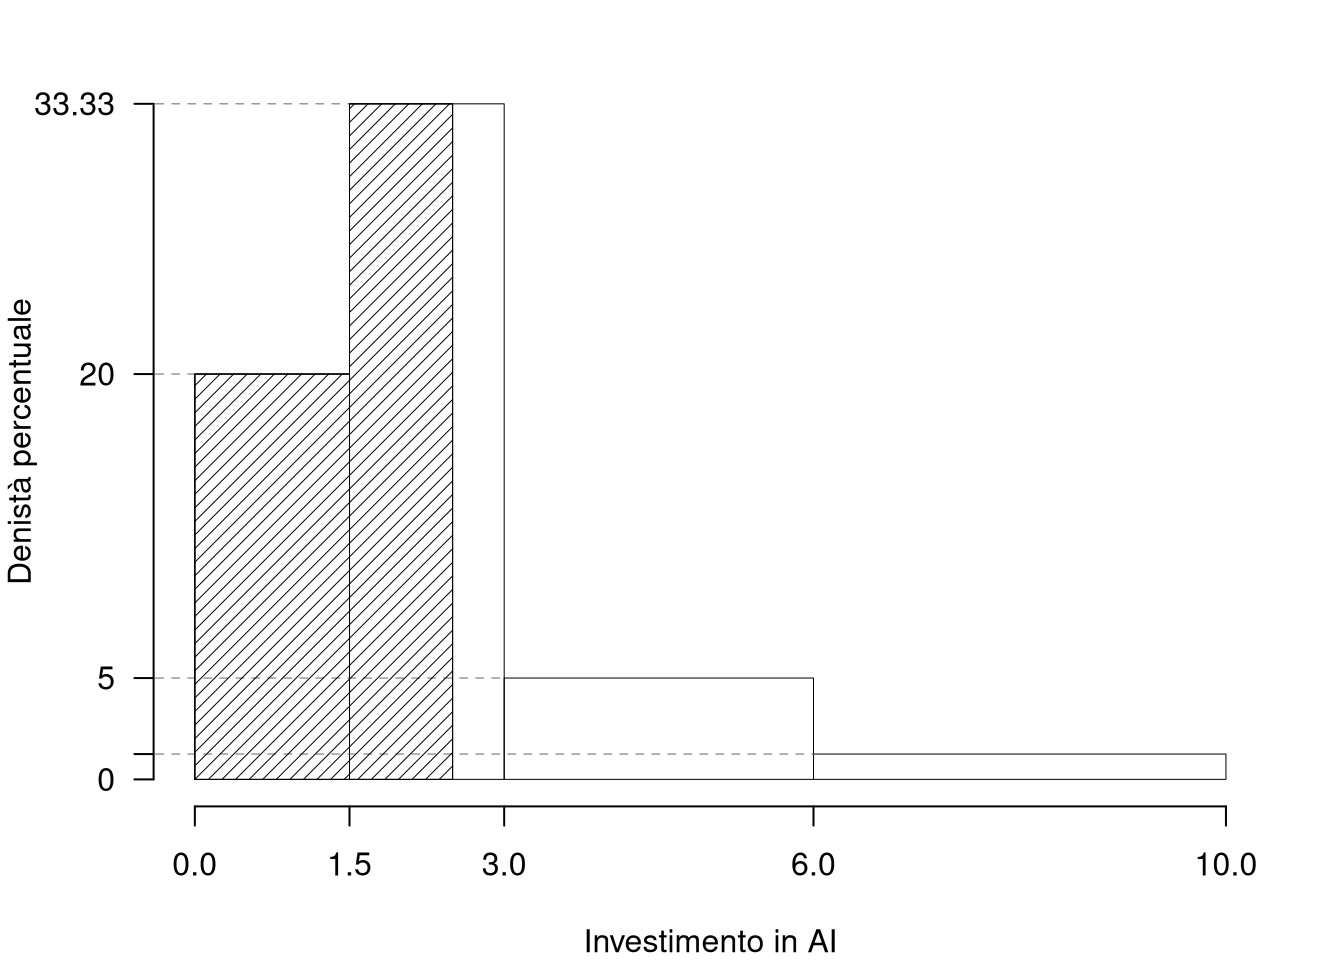
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero approssimativo di aziende hanno investito meno di 2.5 milioni di euro?
\[\begin{eqnarray*} \%(X< 2.5 ) &=& f_{ 1 }\times 100 +( 2.5 - 1.5 )\times h_{ 2 } \\ &=& ( 0.3 )\times 100 +( 1 )\times 33.33 \\ &=& 0.6333 \times(100) \\ \#(X< 2.5 ) &\approx& 127 \end{eqnarray*}\]
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Che relazione dobbiamo aspettarci tra media, mediana e moda?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) L’investimento medio è pari a \(\bar x=2.4\), mentre la varianza è pari a \(\sigma^2=3.1\). Se ogni impresa aumentasse il proprio investimento del 10%, quanto varrebbero la media e la varianza dei dati così trasformati?
\[ \bar y= 2.64 ~~~~~~~~ \sigma^2_Y= 3.751 \]
Esercizio 2
Un processo è svolto da \(n=5\) agenti AI, ogni agente commette un’allucinazione con probabilità \(\pi=0.25\). Sia \(X_i\) la VC che vale 1 se l’agente \(i\) ha commesso un’allucinazione e vale 0 altrimenti: \[ P(X_i = 1) = 0.25, \qquad i =1,...,5 \] e sia \[ X=X_1+...+X_5 \] la VC che conta il numero di allucinazioni su 5 agenti.
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che il processo abbia al massimo un’allucinazione (\(P(X\le 1)\)).
\[ X=X_1 + ... + X_5 \sim \operatorname{Binom}(5;0.25) \] \[\begin{eqnarray*} P( X \leq 1 ) &=& \binom{ 5 }{ 0 } 0.25 ^{ 0 }(1- 0.25 )^{ 5 - 0 }+\binom{ 5 }{ 1 } 0.25 ^{ 1 }(1- 0.25 )^{ 5 - 1 } \\ &=& 0.2373+0.3955 \\ &=& 0.6328 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) Calcolare la probabilità che \(P(X\le 1|X\le 2)\).
\[ X=X_1 + ... + X_5 \sim \operatorname{Binom}(5;0.25) \]
\[\begin{eqnarray*} P(X\le 1|X\le 2) &=& \frac{P(X\le 1\cap X\le 2)}{P(X\le 2)}\\ &=& \frac{P(X\le 1)}{P(X\le 2)}\\ &=& \frac{0.6328}{0.8965}\\ &=& 0.7059 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(X_1\sim \text{Pois}(0.5)\), \(X_2\sim \text{Pois}(1.5)\) e \(X_3\sim \text{Ber}(0.5)\), 3 Poisson indipendenti. Come si distribuisce \(X=X_1+X_2+X_3\)?
\[ X_1+X_2+X_3 \sim \text{Binom}(3,0.5) \]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\ne\emptyset\) e \(B\ne\emptyset\), tali che \(P(B|A)=0.5\) e \(P(A)=0.6\), \(A\) e \(B\) possono essere incompatibili? Perché?
No, perché se lo fossero avremmo che \(P(A\cap B)=0\) e di conseguenza \[ P(A\cup B)= P(A)+P(B)=0.5+0.6> 1 \] che è impossibile.
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 palline numerate con \(\fbox{0}\), 3 numerate con \(\fbox{1}\) e 1 numerate con \(\fbox{2}\). Si estrae 80 volte con reinserimento. Qual è la probabilità che la somma delle 80 palline sia inferiore a 75?
\[\begin{eqnarray*} \mu &=& \frac 1{ 5 }( 0 + 1 + 1 + 1 + 2 )= 1 \\ \sigma^2 &=& \frac 1{ 5 }( 0 ^2+ 1 ^2+ 1 ^2+ 1 ^2+ 2 ^2 )-( 1 )^2= 0.4 \end{eqnarray*}\] Teorema del Limite Centrale (somma VC qualunque)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(E(X_i)=\mu=1\) e \(V(X_i)=\sigma^2=0.4,\forall i\), posto: \[ S_n = X_1 + ... + X_n \] allora:\[\begin{eqnarray*} S_n & \mathop{\sim}\limits_{a}& N(n\mu,n\sigma^2) \\ &\sim & N(80\cdot1,80\cdot0.4) \\ &\sim & N(80,32) \end{eqnarray*}\]\[\begin{eqnarray*} P( S_n < 75 ) &=& P\left( \frac { S_n - n\mu }{ \sqrt{n\sigma^2} } < \frac { 75 - 80 }{\sqrt{ 32 }} \right) \\ &=& P\left( Z < -0.88 \right) \\ &=& 1-\Phi( 0.88 ) \\ &=& 0.1894 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Si supponga di avere un modello \(\mathscr{M}(\theta;\psi)\), che dipende da due parametri: \(\theta\) che è un indicatore di centralità e \(\psi>0\) che è un indicatore di dispersione. Sia \(\hat \theta\) lo stimatore di massima verosimiglianza di \(\theta\). Sono noti \[\begin{eqnarray*} E(\hat\theta) &=& \theta+\frac \psi n\\ V(\hat\theta) &=& \frac{\psi^2}n \end{eqnarray*}\] Dimostrare la consistenza di \(\hat \theta\).
Quindi \(\hat\theta\) è consistente in media quadratica, e dunque consistente.
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\theta\) lo stimatore di massima verosimiglianza per \(\theta\), indicare la sua distribuzione asintotica.
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Definire il \(p_\text{value}\).
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) Una moneta, che non sappiamo se è perfetta oppure no, viene lanciata 100 volte. Abbiamo osservato 34 volte testa su 100 lanci. Posto \(\pi\) la probabilità che la moneta mostri testa, si è testato \[ \begin{cases} H_0:\pi=\frac 12\\ H_1:\pi\ne\frac 12 \end{cases} \] ed è risultato \(p_\text{value}=0.0014\). Possiamo concludere che la moneta sia truccata? Perché?
Esercizio 5
In uno studio su (n=50) municipalità dell’Unione Europea, sono stati analizzati il numero di centraline per la ricarica delle auto elettriche per chilometro quadrato (X) e una misura della qualità dell’aria espressa in opportuna scala (Y).
Si osservano le seguenti statistiche: \(\sum_{i=1}^{50}x_i=497.7\), \(\sum_{i=1}^{50}y_i=113.92\), \(\sum_{i=1}^{50}x_i^2=5123.67\), \(\sum_{i=1}^{50}y_i^2=262.03\) e \(\sum_{i=1}^{50}x_iy_i=1151.85\).
5.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per la regione \(R\) si è osservato \(x_R=10.1\) e \(y_R=2.24\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per la regione \(R\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 497.7 = 9.954 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 113.92 = 2.278 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5124 - 9.954 ^2= 3.391 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 262 - 2.2784 ^2= 0.04949 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 1152 - 9.954 \cdot 2.2784 = 0.3578 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ 0.3578 }{ 3.391 } = 0.1055 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 2.278 - 0.1055 \times 9.954 = 1.228 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 1.228 + 0.1055 \times 10.1 = 2.294 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 2.238 - 2.2938 = -0.05583 \end{eqnarray*}\]
5.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ 0.3578 }{ 1.842 \times 0.2225 }= 0.8733 \\ r^2&=& 0.7627 > 0.75 \end{eqnarray*}\]
Il modello si adatta bene ai dati.
Il modello spiega il \(76.27\%\) della variabilità totale della \(Y\).
5.c (Punti 13/103 \(\rightarrow\) 3.9/31) Testare l’ipotesi che \(\beta_0 = 1\) contro l’alternativa che sia diverso.
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \beta_0 = \beta_{0;H_0}=1 \\ H_1: \beta_0 \neq \beta_{0;H_0}=1 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(T\) Test su un coefficiente di regressione: \(\Rightarrow\) t-Test.
\[\begin{eqnarray*} \hat{\sigma_\varepsilon}^2&=&(1-r^2)\hat\sigma_Y^2\\ &=& (1- 0.7627 )\times 0.0495 \\ &=& 0.0117 \\ S_\varepsilon^2 &=& \frac{n} {n-2} \hat{\sigma_\varepsilon}^2\\ &=& \frac{ 50 } { 50 -2} \hat{\sigma_\varepsilon}^2 \\ &=& \frac{ 50 } { 50 -2} \times 0.0117 = 0.0122 \end{eqnarray*}\]
E quindi\[\begin{eqnarray*}
V(\hat\beta_{0}) &=& \sigma_{\varepsilon}^{2} \left( \frac{1} {n} + \frac{\bar{x}^{2}} {n \hat{\sigma}^{2}_{X}} \right)\\
\widehat{V(\hat\beta_{0})} &=& S_{\varepsilon}^{2}\left( \frac{1} {n} + \frac{\bar{x}^{2}} {n \hat{\sigma}^{2}_{X}} \right)\ \\
&=& 0.0122 \times\left( \frac{1} { 50 } + \frac{ 9.954 ^{2}} { 50 \times 3.391 } \right)\\
\widehat{SE(\hat\beta_{0})} &=& \sqrt{ 0.0074 }\\
&=& 0.08602
\end{eqnarray*}\]
\[\begin{eqnarray*}
\frac{\hat\beta_{ 0 } - \beta_{ 0 ;H_0}} {\widehat{SE(\hat\beta_{ 0 })}}&\sim&t_{n-2}\\
t_{\text{obs}}
&=& \frac{ ( 1.228 - 1 )} { 0.08598 }
= 2.654 \, .
\end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Siccome \(H_1\) è bilaterale, considereremo \(\alpha/2\), anziché \(\alpha\)
\(\alpha=0.1, 0.05, 0.01, 0.001\) e quindi \(\alpha/2=0.05, 0.025, 0.005, 0.0005\)
I valori critici sono
\(t_{50-2;0.05}=1.6772\); \(t_{50-2;0.025}=2.0106\); \(t_{50-2;0.005}=2.6822\); \(t_{50-2;0.0005}=3.5051\)
Siccome \(2.0106<|t_\text{obs}|=2.654<2.6822\), quindi rifiuto \(H_0\) al 5%,
\(0.01<p_\text{value}<0.05\), significativo \(\fbox{*}\).
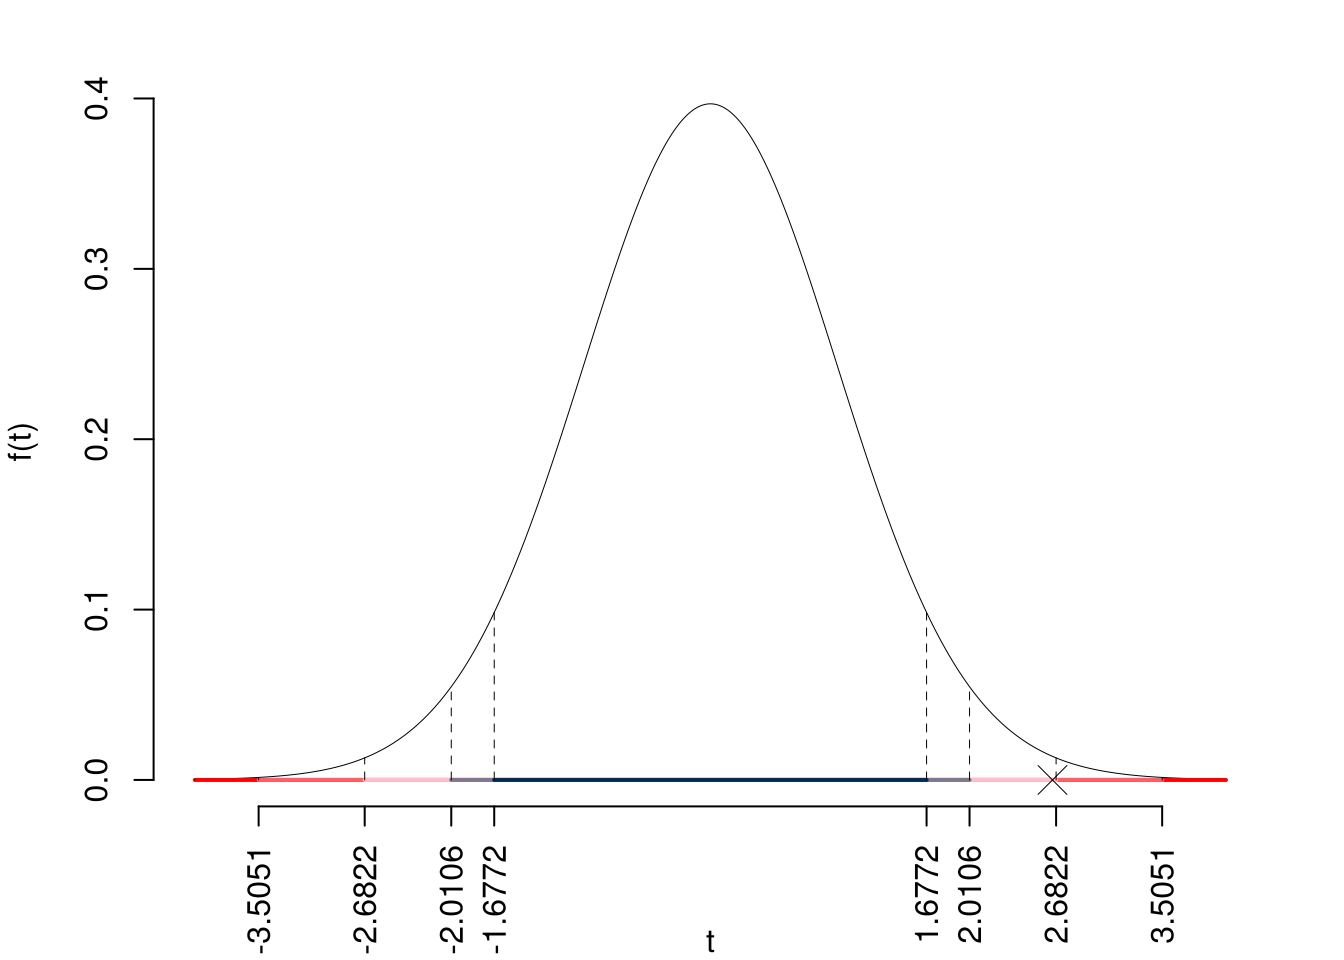
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(|T_{50-2}|>|2.65|)=2P(T_{50-2}>2.65)=0.010755 \]
Attenzione il calcolo del \(p_\text{value}\) con la \(T\) è puramente illustrativo e non può essere riprodotto senza una calcolatrice statistica adeguata.\[ 0.01 < p_\text{value}= 0.010755 \leq 0.05 \]
5.d (Punti 2/103 \(\rightarrow\) 0.6/31) Definire gli outliers e i punti di leva.
5.e (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione \(\hat\beta_1 >0\) che segno avrà \(r\)?
5.f (Punti 2/103 \(\rightarrow\) 0.6/31) Cosa significa quando \(r^2=0\)?
Prova di Statistica 2026/06/12-1
Esercizio 1
Su un campione di \(200\) aziende con più di 50 addetti dell’Emilia-Romagna è stato rilevato l’investimento effettuato negli ultimi 5 anni in intelligenza artificiale (espresso in milioni di euro). Di seguito è riportata la distribuzione delle frequenze percentuali:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(f_{j\%}\) |
|---|---|---|
| 0 | 1 | 65 |
| 1 | 3 | 25 |
| 3 | 5 | 5 |
| 5 | 10 | 5 |
| 100 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Disegnare l’istogramma di densità percentuale.
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 1 | 130 | 0.65 | 1 | 65.0 |
| 1 | 3 | 50 | 0.25 | 2 | 12.5 |
| 3 | 5 | 10 | 0.05 | 2 | 2.5 |
| 5 | 10 | 10 | 0.05 | 5 | 1.0 |
| 200 | 1.00 | 10 |
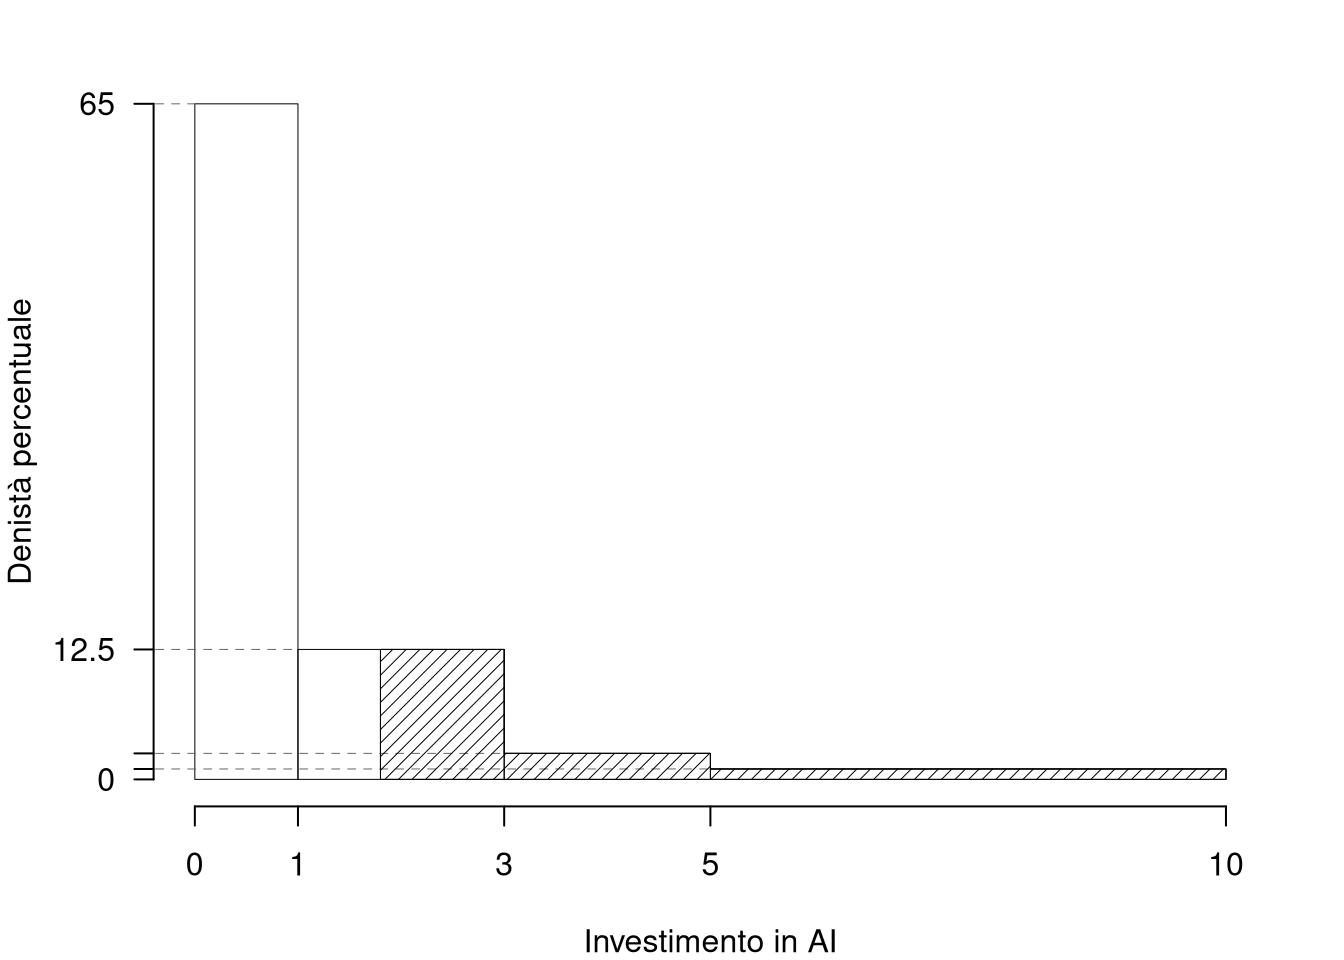
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero di aziende che hanno investito tra il 25-esimo e il 75-esimo percentile?
Per definizione \(\%(x_{0.25}<X<x_{0.75})=50\%\) e \(\#(x_{0.25}<X<x_{0.75})\approx0.5\times200 =100\)
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Che relazione dobbiamo aspettarci tra media, mediana e moda?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(x_1,...,x_{10}\), \(n=10\) numeri tali che \[ \sum_{i=1}^{10} x_i = 15 \] Posto \[ g(x)=\sum_{i=1}^{10}(x_i-x)^2 \] calcolare il valore di \(x\) che minimizza \(g\).
Esercizio 2
Un processo viene svolto da due agenti AI, \(A\) e \(B\). L’agente \(A\) commette un numero di allucinazioni che è distribuito secondo una Poisson di parametro 0.05, \(X_A \sim \text{Pois}(0.05)\), mentre per l’agente \(B\) il numero di allucinazioni è distribuito secondo una Poisson di parametro 0.03, \(X_B \sim \text{Pois}(0.03)\), \(X_A\) e \(X_B\) indipendenti. Il processo finale viene considerato inconsistente se gli agenti hanno commesso almeno una allucinazione (\(X_A+X_B\ge 1\)).
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che il processo sia inconsistente (\(X_A + X_B\ge 1\)).
\[ X_A + X_B \sim \text{Pois}(0.05+0.03) \] \[\begin{eqnarray*} P( X_A+X_B \geq 1 ) &=& 1-P( X_A+X_B < 1 ) \\ &=& 1-\left( \frac{ 0.08 ^{ 0 }}{ 0 !}e^{- 0.08 } \right)\\ &=& 1-( 0.9231 )\\ &=& 1- 0.9231 \\ &=& 0.0769 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) Si considerino \(n=5\) ripetizioni indipendenti del processo. Per ogni ripetizione \(i\), sia \(X_i=X_A+X_B\) il numero totale di allucinazioni commesse dai due agenti nel processo \(i\).
Calcolare la probabilità che almeno uno dei 5 processi risulti inconsistente, cioè che in almeno una ripetizione si abbia \(X_i\ge 1\). (Suggerimento: l’evento complementare di “almeno uno dei 5 processi è inconsistente” è “nessuno dei 5 processi è inconsistente”)
\[\begin{eqnarray*} P(X_A + X_B \ge 1) &=& 1 - P(X_A + X_B = 0) \\ &=& 0.0769\\ P(\text{almeno una volta}) &=& 1-P(\text{nessuna volta})\\ &=& 1-(1-0.0769)^5\\ &=& 0.3297 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Sia \(Z\sim N(0,1)\) e \(Y\sim \text{Binom}(5,0.4)\), \(Z\) e \(Y\) indipendenti. Calcolare \(E(Z-Y)\) e \(V(Z-Y)\).
essendo
\[\begin{align} E(Z) &= 0; & \qquad V(Z) & = 1\\ E(Y) &=5\times 0.4 = 2; & \qquad V(Y) & = 5\times 0.4\times(1-0.4)=1.2\\ \end{align}\]
e quindi
\[\begin{eqnarray*} E(Z-Y) &=& 0-2\\ V(Z-Y) &=& 1+1.2\\ \end{eqnarray*}\]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\ne\emptyset\) e \(B\ne\emptyset\), tali che \(A\cap B = \emptyset\), \(A\) e \(B\) possono essere indipendenti? Perché?
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 pallina numerata con \(\fbox{0}\), 3 numerate con \(\fbox{1}\) e 1 numerata con \(\fbox{2}\). Si vince se esce \(\fbox{1}\) oppure \(\fbox{2}\) e si perde altrimenti. Si estrae 80 volte con reinserimento. Qual è la probabilità che la proporzione di vincite sia maggiore di 0.75?
Teorema del Limite Centrale (proporzione)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(X_i\sim\text{Ber}(\pi=0.8)\)\(,\forall i\), posto: \[ \hat\pi=\frac{S_n}n = \frac{X_1 + ... + X_n}n \] allora:\[\begin{eqnarray*} \hat\pi & \mathop{\sim}\limits_{a}& N(\pi,\pi(1-\pi)/n) \\ &\sim & N\left(0.8,\frac{0.8\cdot(1-0.8)}{80}\right) \\ &\sim & N(0.8,0.002) \end{eqnarray*}\]\[\begin{eqnarray*} P( \hat\pi > 0.75 ) &=& P\left( \frac { \hat\pi - \pi }{ \sqrt{\pi(1-\pi)/n} } > \frac { 0.75 - 0.8 }{\sqrt{ 0.002 }} \right) \\ &=& P\left( Z > -1.12 \right) \\ &=& 1-P(Z< -1.12 )\\ &=& 1-(1-\Phi( 1.12 )) \\ &=& 0.8686 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\beta_0\), \(\hat\beta_1\) e \(\hat\sigma_\varepsilon\) gli stimatori di massima verosimiglianza di, \(\beta_0\), \(\beta_1\) e \(\sigma_\varepsilon\), del modello di regressione lineare semplice \[ y_i = \beta_0 + \beta_1 x_i +\varepsilon_i, ~\varepsilon_i\sim N(0,\sigma^2_\varepsilon),\forall i=1,...,n \] Dimostrare la consistenza di \(\hat\beta_0\).
Sappiamo che \(\hat\beta_0\) è stimatore corretto di \(\beta_0\) (teroema di Gauss-Markov): \[ E(\hat\beta_0)=\beta_0 \] Quindi, essendo corretto \[\begin{eqnarray} MSE(\hat\beta_0) &=& V(\hat\beta_0)\\ &=&\sigma_{\varepsilon}^{2} \left( \frac{1} {n} + \frac{\bar{x}^{2}} {n \hat{\sigma}^{2}_{X}} \right)\qquad\text{dal formulario} \end{eqnarray}\] Siccome \[ \lim_{n\to\infty}\sigma_{\varepsilon}^{2} \left( \frac{1} {n} + \frac{\bar{x}^{2}} {n \hat{\sigma}^{2}_{X}} \right)=0 \] allora \(\hat\beta_0\) è stimatore consistente di \(\beta_0\).
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\theta_1\) e \(\hat\theta_2\) due stimatori corretti per \(\theta\), cosa significa dire che \(\hat\theta_1\) è più efficiente di \(\hat\theta_2\)?
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Definire gli errori di primo e secondo tipo di un test statistico e le relative probabilità.
Si definiscono
- L’errore di primo tipo è l’errore che si commette scegliendo \(H_1\) quando è vera \(H_0\).
- L’errore di secondo tipo è l’errore che si commette scegliendo \(H_0\) quando è vera \(H_1\).
| decido \(H_0\) | decido \(H_1\) | ||
|---|---|---|---|
| stato di natura | \(H_0\) | \(1-\alpha\) | \(\alpha\) |
| stato di natura | \(H_1\) | \(\beta\) | \(1-\beta\) |
\[\alpha=P(\text{Errore I tipo})=P(\text{Decidere $H_1$};H_0)\]
\[\beta=P(\text{Errore II tipo})=P(\text{Decidere $H_0$};H_1)\]
- \(\alpha\) è il livello di significatività del test, \(\alpha\) è la probabilità di scegliere \(H_1\) quando invece è vera \(H_0\).
- \(\beta\) è la probabilità di scegliere \(H_0\) quando invece è vera \(H_1\).
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) In un sondaggio su 160 persone è stato chiesto il livello di utilizzo di strumenti di Intelligenza Artificiale (Basso, Medio, Alto) e l’opinione sul loro impatto nel mondo del lavoro (Favorevole, Contrario).
|
Livello di utilizzo
|
|||
|---|---|---|---|
| Basso | Medio | Alto | |
| Opinione | |||
| Favorevole | 30 | 10 | 35 |
| Contrario | 20 | 40 | 25 |
Eseguito il test del \(\chi^2\) per verificare l’indipendenza tra il livello di utilizzo degli strumenti di AI e l’opinione sul loro impatto nel mondo del lavoro, si ottiene un \(p_\text{value}=0.00002588\). Possiamo concludere che il livello di utilizzo e l’opinione sul loro impatto nel mondo del lavoro sono indipendenti? Perché?
Essendo \(p_\text{value}=0.00002588<0.001\) il test è estremamente significativo, si rifiuta l’indipendenza tra il livello di utilizzo e l’opinione sull’impatto ad un livello di significatività inferiore all’1 per mille.
Esercizio 5
In uno studio su \(n=50\) municipalità dell’Unione Europea, sono stati analizzati il tasso di disoccupazione giovanile (in percentuale, \(X\)) e la disponibilità di aree verdi urbane (in metri quadrati per abitante, \(Y\)).
Si sono osservate le seguenti statistiche: \[\begin{align*} \sum_{i=1}^n x_i &= 498, &\sum_{i=1}^n x_i^2 &= 5025.18 & \\ \sum_{i=1}^n y_i &= 1289.27, &\sum_{i=1}^n y_i^2 &= 36923.54 &\sum_{i=1}^n x_iy_i &= 12393.43. \end{align*}\]
5.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per la regione \(R\) si è osservato \(x_R=10.6\) e \(y_R=24.48\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per la regione \(R\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 498 = 9.96 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 1289.27 = 25.79 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5025 - 9.96 ^2= 1.302 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 36924 - 25.7854 ^2= 73.58 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 12393 - 9.96 \cdot 25.7854 = -8.954 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ -8.954 }{ 1.302 } = -6.877 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 25.79 - (-6.8771) \times 9.96 = 94.28 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 94.28 + (-6.8771) \times 10.6 = 21.38 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 24.48 - 21.3841 = 3.098 \end{eqnarray*}\]
5.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ -8.954 }{ 1.141 \times 8.578 }= -0.9148 \\ r^2&=& 0.8368 > 0.75 \end{eqnarray*}\]
Il modello si adatta bene ai dati.
Il modello spiega il \(83.68\%\) della variabilità totale della \(Y\).
5.c (Punti 13/103 \(\rightarrow\) 3.9/31) Testare l’ipotesi che \(\beta_1 = -5\) contro l’alternativa che sia diverso, per \(\alpha=0.1,0.05,0.01,0.001\) e dare una valutazione approssimativa del \(p_\text{value}\) (ad esempio il \(p_\text{value}\) è minore di 0.001, compreso tra 0.05 e tra 0.01, ecc.).
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \beta_1 = \beta_{1;H_0}=-5.5 \\ H_1: \beta_1 \neq \beta_{1;H_0}=-5.5 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(T\) Test su un coefficiente di regressione: \(\Rightarrow\) t-Test.
\[\begin{eqnarray*} \hat{\sigma_\varepsilon}^2&=&(1-r^2)\hat\sigma_Y^2\\ &=& (1- 0.8369 )\times 73.58 \\ &=& 12.01 \\ S_\varepsilon^2 &=& \frac{n} {n-2} \hat{\sigma_\varepsilon}^2\\ &=& \frac{ 50 } { 50 -2} \hat{\sigma_\varepsilon}^2 \\ &=& \frac{ 50 } { 50 -2} \times 12.01 = 12.51 \end{eqnarray*}\]
E quindi\[\begin{eqnarray*} V(\hat\beta_{1}) &=& \frac{\sigma_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ \widehat{V(\hat\beta_{1})} &=& \frac{S_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ &=& \frac{ 12.51 } { 50 \times 1.302 } = 0.1921 \\ \widehat{SE(\hat\beta_{1})} &=& \sqrt{ 0.1921 }\\ &=& 0.4383 \end{eqnarray*}\]
\[\begin{eqnarray*} \frac{\hat\beta_{ 1 } - \beta_{ 1 ;H_0}} {\widehat{SE(\hat\beta_{ 1 })}}&\sim&t_{n-2}\\ t_{\text{obs}} &=& \frac{ ( -6.877 - -5.5 )} { 0.4383 } = -3.142 \, . \end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Siccome \(H_1\) è bilaterale, considereremo \(\alpha/2\), anziché \(\alpha\)
\(\alpha=0.1, 0.05, 0.01, 0.001\) e quindi \(\alpha/2=0.05, 0.025, 0.005, 0.0005\)
I valori critici sono
\(t_{50-2;0.05}=1.6772\); \(t_{50-2;0.025}=2.0106\); \(t_{50-2;0.005}=2.6822\); \(t_{50-2;0.0005}=3.5051\)
Siccome \(2.6822<|t_\text{obs}|=3.1416<3.5051\), quindi rifiuto \(H_0\) all’1%,
\(0.001<p_\text{value}<0.01\), molto significativo \(\fbox{**}\).
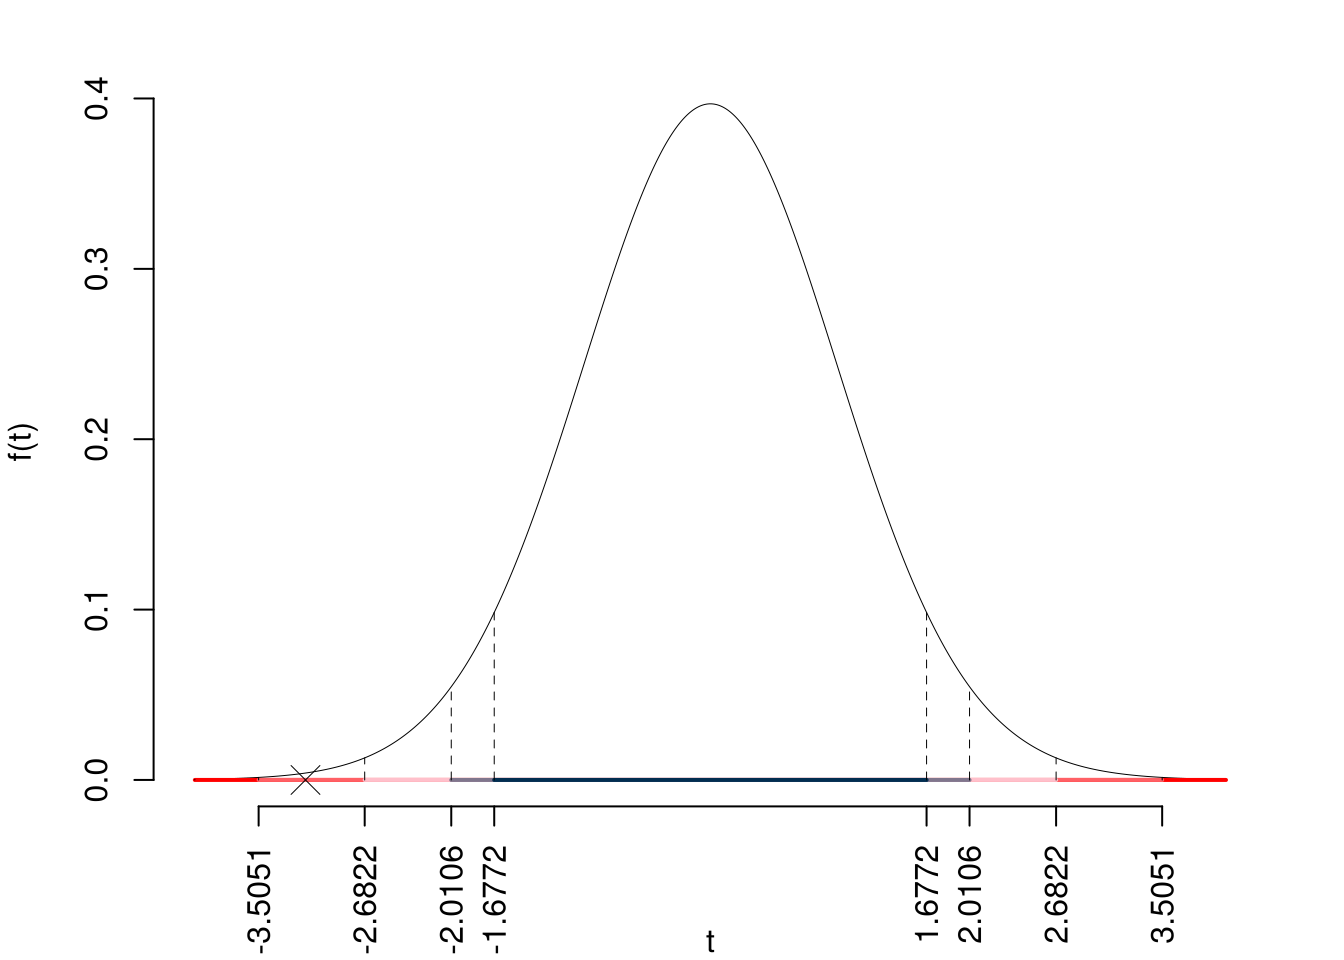
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(|T_{50-2}|>|-3.14|)=2P(T_{50-2}>3.14)=0.002877 \]
Attenzione il calcolo del \(p_\text{value}\) con la \(T\) è puramente illustrativo e non può essere riprodotto senza una calcolatrice statistica adeguata.\[ 0.001 < p_\text{value}= 0.002877 \leq 0.01 \]
5.d (Punti 2/103 \(\rightarrow\) 0.6/31) Perché, nel modello stimato al punto 5a, una previsione per \(x=10\) è più precisa di una previsione per \(x=100\)?
5.e (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione lineare \(\hat\beta_1 =0\) quanto vale \(r\)?
5.f (Punti 2/103 \(\rightarrow\) 0.6/31) In un modello di regressione lineare, cosa comporta \(r=-1\)?
Prova di Statistica 2026/06/12-2
Esercizio 1
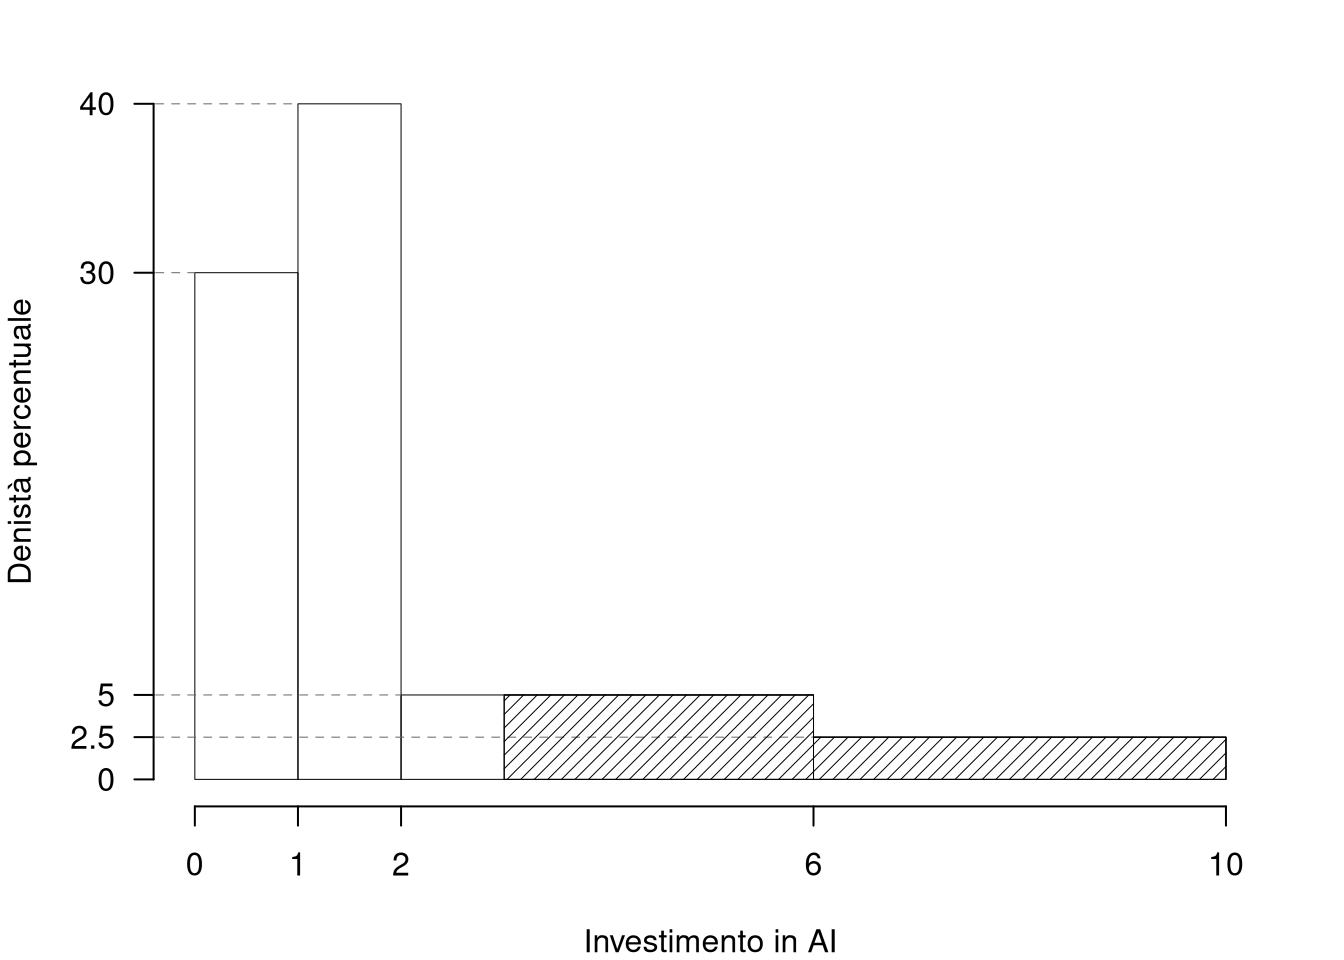
Su un campione di \(150\) aziende con più di 50 addetti dell’Emilia-Romagna è stato rilevato l’investimento effettuato negli ultimi 5 anni in intelligenza artificiale (espresso in milioni di euro). Di seguito è riportata la distribuzione delle densità percentuali:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(h_j\) |
|---|---|---|
| 0 | 1 | 30.0 |
| 1 | 2 | 40.0 |
| 2 | 6 | 5.0 |
| 6 | 10 | 2.5 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare il valore approssimativo della mediana.
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 1 | 45 | 0.3 | 1 | 30.0 |
| 1 | 2 | 60 | 0.4 | 1 | 40.0 |
| 2 | 6 | 30 | 0.2 | 4 | 5.0 |
| 6 | 10 | 15 | 0.1 | 4 | 2.5 |
| 150 | 1.0 | 10 |
\[\begin{eqnarray*}
p &=& 0.5 , \text{essendo }F_{ 2 }= 0.7 > 0.5 \Rightarrow j_{ 0.5 }= 2 \\
x_{ 0.5 } &=& x_{\text{inf}; 2 } + \frac{ { 0.5 } - F_{ 1 }} {f_{ 2 }} \cdot b_{ 2 } \\
&=& 1 + \frac {{ 0.5 } - 0.3 } { 0.4 } \cdot 1 \\
&=& 1.5
\end{eqnarray*}\]
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero approssimativo di aziende che hanno investito più di 3 milioni di euro?
\[\begin{eqnarray*} \%(X> 3 ) &=& ( 6 - 3 )\times h_{ 3 }+ f_{ 4 }\times 100 \\ &=& ( 3 )\times 5 + ( 0.1 )\times 100 \\ &=& 0.25 \times(100)\\ \#(X> 3 ) &\approx& 38 \end{eqnarray*}\]
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Sapendo che le media è pari a \(2.4\) e considerata la mediana calcolata al punto 1.a, che forma avrà l’istogramma di densità?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) L’investimento medio è pari a \(\bar x=2.4\), mentre la varianza è pari a \(\sigma^2=5.1\). Se ogni impresa aumentasse il proprio investimento di un milione di euro, quanto varrebbero la media e la varianza dei dati così trasformati?
\[ \bar y= 3.4 ~~~~~~~~ \sigma^2_Y= 5.1 \]
Esercizio 2
Un processo viene svolto da due agenti AI in sequenza, prima \(A\) e poi \(B\). Il tempo impiegato dall’agente \(A\), misurato in secondi, è distribuito secondo una Normale con media 8 e varianza 1, \(X_A \sim N(8,1)\), mentre il tempo impiegato dall’agente \(B\) è distribuito secondo una Normale con media 10 e varianza 3, \(X_B \sim N(10,3)\), con \(X_A\) e \(X_B\) indipendenti. Il processo finale viene considerato troppo lento se il tempo complessivo supera 22 secondi.
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che il processo sia troppo lento (\(P(X_A+X_B>22)\)).
\[ X=X_A + X_B \sim N(8+10,1+3) \] \[\begin{eqnarray*} P( X > 22 ) &=& P\left( \frac { X - \mu }{ \sigma } > \frac { 22 - 18 }{\sqrt{ 4 }} \right) \\ &=& P\left( Z > 2 \right) \\ &=& 1-P(Z< 2 )\\ &=& 1-\Phi( 2 ) \\ &=& 0.0228 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) Calcolare \(P(X_A + X_B\le 23|X_A + X_B> 22)\).
\[ X=X_A + X_B \sim N(8+10,1+3) \]
\[\begin{eqnarray*} P(X\le 23|X> 22) &=& \frac{P(X\le 23\cap X> 22)}{P(X> 22)}\\ &=& \frac{P(22<X\le 23)}{P(X> 22)}\\ &=& \frac{0.9938-0.9772}{0.0228}\\ &=& 0.727 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(X_1\sim \text{Ber}(0.5)\), \(X_2\sim \text{Ber}(0.5)\) e \(X_3\sim \text{Ber}(0.5)\), 3 Bernoulli indipendenti. Come si distribuisce \(X=X_1+X_2+X_3\)?
\[ X_1+X_2+X_3 \sim \text{Binom}(3,0.5) \]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\) e \(B\) due eventi, tali che \(P(B|A)=0.5\), \(P(B|\bar A)=0.4\) e \(P(A)=0.3\), calcolare \(P(B)\).
\[\begin{eqnarray*} P(B) &=& P(B|A)P(A)+P(B|\bar A)P(\bar A)\\ &=& 0.5\times 0.3+ 0.4\times(1-0.3)\\ &=& 0.43 \end{eqnarray*}\]
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 pallina numerata con \(\fbox{0}\), 3 numerate con \(\fbox{1}\) e 1 numerata con \(\fbox{2}\). Si vince se esce \(\fbox{1}\) oppure \(\fbox{2}\) e si perde altrimenti. Si estrae 80 volte con reinserimento. Qual è la probabilità di vincere meno di 60 volte?
Teorema del Limite Centrale (somma di Bernoulli)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(X_i\sim\text{Ber}(\pi=0.8)\)\(,\forall i\), posto: \[ S_n = X_1 + ... + X_n \] allora:\[\begin{eqnarray*} S_n & \mathop{\sim}\limits_{a}& N(n\pi,n\pi(1-\pi)) \\ &\sim & N(80\cdot0.8,80\cdot0.8\cdot(1-0.8)) \\ &\sim & N(64,12.8) \end{eqnarray*}\]\[\begin{eqnarray*} P( S_n < 60 ) &=& P\left( \frac { S_n - n\pi }{ \sqrt{n\pi(1-\pi)} } < \frac { 60 - 64 }{\sqrt{ 12.8 }} \right) \\ &=& P\left( Z < -1.12 \right) \\ &=& 1-\Phi( 1.12 ) \\ &=& 0.1314 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\beta_0\), \(\hat\beta_1\) e \(\hat\sigma_\varepsilon\) gli stimatori di massima verosimiglianza di, \(\beta_0\), \(\beta_1\) e \(\sigma_\varepsilon\), del modello di regressione lineare semplice \[ y_i = \beta_0 + \beta_1 x_i +\varepsilon_i, ~\varepsilon_i\sim N(0,\sigma^2_\varepsilon),\forall i=1,...,n \] Dimostrare la consistenza di \(\hat\beta_1\).
Sappiamo che \(\hat\beta_1\) è stimatore corretto di \(\beta_1\) (teorema di Gauss-Markov): \[ E(\hat\beta_1)=\beta_1 \] Quindi, essendo corretto \[\begin{eqnarray} MSE(\hat\beta_1) &=& V(\hat\beta_1)\\ &=&\frac{\sigma_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \qquad \text{dal formulario} \end{eqnarray}\] Siccome \[ \lim_{n\to\infty}\frac{\sigma_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}}=0 \] allora \(\hat\beta_1\) è stimatore consistente di \(\beta_1\).
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\theta_1\) e \(\hat\theta_2\) due stimatori non corretti per \(\theta\), cosa significa dire che \(\hat\theta_1\) è più efficiente di \(\hat\theta_2\)?
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Si consideri il seguente sistema d’ipotesi: \[ \begin{cases} H_0:\theta=\theta_0\\ H_1:\theta>\theta_0 \end{cases} \]
Posta con \(T\) la VC statistica test e con \(t_\text{obs}\) il valore osservato della statistica test, definire il \(p_\text{value}\) del test.
Il \(p_\text{value}\) è la probabilità, se fosse vera \(H_0\) di avere un campione ancora più favorevole ad \(H_1\) di quello che abbiamo osservato, in altre parole ci dice quanto è raro il campione sotto ipotesi \(H_0\). In simboli, nel caso di un test unilaterale destro \[ p_\text{value} = P(T>t_\text{obs}) \]
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) In un sondaggio su 273 lavoratori è stato chiesto il livello di formazione ricevuta sull’uso degli strumenti di Intelligenza Artificiale (Basso, Medio, Alto) e la valutazione della propria preparazione rispetto ai cambiamenti tecnologici nel lavoro (Adeguata, Insufficiente).
|
Livello di formazione
|
|||
|---|---|---|---|
| Basso | Medio | Alto | |
| Preparazione | |||
| Adeguata | 18 | 32 | 45 |
| Insufficiente | 40 | 40 | 98 |
Eseguito il test del \(\chi^2\) per verificare l’indipendenza tra il livello di formazione sugli strumenti di AI e la valutazione della preparazione rispetto ai cambiamenti tecnologici, si ottiene un \(p_\text{value}=0.1344\). Possiamo concludere che il livello di formazione ricevuta e la propria valutazione rispetto alla propria preparazione sono indipendenti? Perché?
Essendo \(p_\text{value}=0.1344>0.1\) il test non è significativo, non si rifiuta l’indipendenza tra il livello di utilizzo e l’opinione sull’impatto per nessun livello di significatività.
Esercizio 5
In uno studio su \(n=50\) municipalità dell’Unione Europea, sono stati analizzati il tasso di disoccupazione giovanile (in percentuale, \(X\)) e il numero di posti a sedere in teatro e cinema per abitante (\(Y\)).
Si sono osservate le seguenti statistiche: \[\begin{align*} \sum_{i=1}^n x_i &= 500.4, &\sum_{i=1}^n x_i^2 &= 5047.02 & \\ \sum_{i=1}^n y_i &= 114.68, &\sum_{i=1}^n y_i^2 &= 263.79 &\sum_{i=1}^n x_iy_i &= 1151.3. \end{align*}\]
5.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per la regione \(R\) si è osservato \(x_R=10.5\) e \(y_R=2.19\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per la regione \(R\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 500.4 = 10.01 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 114.68 = 2.294 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5047 - 10.008 ^2= 0.7803 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 263.8 - 2.2936 ^2= 0.0152 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 1151 - 10.008 \cdot 2.2936 = 0.07166 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ 0.07166 }{ 0.7803 } = 0.09183 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 2.294 - 0.0918 \times 10.008 = 1.375 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 1.375 + 0.0918 \times 10.5 = 2.339 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 2.192 - 2.3388 = -0.1471 \end{eqnarray*}\]
5.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ 0.07166 }{ 0.8834 \times 0.1233 }= 0.658 \\ r^2&=& 0.4329 < 0.75 \end{eqnarray*}\]
Il modello non si adatta bene ai dati.
Il modello spiega il \(43.29\%\) della variabilità totale della \(Y\).
5.c (Punti 13/103 \(\rightarrow\) 3.9/31) Testare l’ipotesi che \(\beta_0 = 1\) contro l’alternativa che sia maggiore, per \(\alpha=0.1,0.05,0.01,0.001\) e dare una valutazione approssimativa del \(p_\text{value}\) (ad esempio il \(p_\text{value}\) è minore di 0.001, compreso tra 0.05 e tra 0.01, ecc.).
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \beta_0 = \beta_{0;H_0}=1 \\ H_1: \beta_0 > \beta_{0;H_0}=1 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(T\) Test su un coefficiente di regressione: \(\Rightarrow\) t-Test.
\[\begin{eqnarray*} \hat{\sigma_\varepsilon}^2&=&(1-r^2)\hat\sigma_Y^2\\ &=& (1- 0.433 )\times 0.0152 \\ &=& 0.0086 \\ S_\varepsilon^2 &=& \frac{n} {n-2} \hat{\sigma_\varepsilon}^2\\ &=& \frac{ 50 } { 50 -2} \hat{\sigma_\varepsilon}^2 \\ &=& \frac{ 50 } { 50 -2} \times 0.0086 = 0.009 \end{eqnarray*}\]
E quindi\[\begin{eqnarray*}
V(\hat\beta_{0}) &=& \sigma_{\varepsilon}^{2} \left( \frac{1} {n} + \frac{\bar{x}^{2}} {n \hat{\sigma}^{2}_{X}} \right)\\
\widehat{V(\hat\beta_{0})} &=& S_{\varepsilon}^{2}\left( \frac{1} {n} + \frac{\bar{x}^{2}} {n \hat{\sigma}^{2}_{X}} \right)\ \\
&=& 0.009 \times\left( \frac{1} { 50 } + \frac{ 10.01 ^{2}} { 50 \times 0.7803 } \right)\\
\widehat{SE(\hat\beta_{0})} &=& \sqrt{ 0.0232 }\\
&=& 0.1523
\end{eqnarray*}\]
\[\begin{eqnarray*}
\frac{\hat\beta_{ 0 } - \beta_{ 0 ;H_0}} {\widehat{SE(\hat\beta_{ 0 })}}&\sim&t_{n-2}\\
t_{\text{obs}}
&=& \frac{ ( 1.375 - 1 )} { 0.1524 }
= 2.458 \, .
\end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Consideriamo \(\alpha=0.1, 0.05, 0.01, 0.001\)
I valori critici sono
\(t_{50-2;0.1}=1.2994\); \(t_{50-2;0.05}=1.6772\); \(t_{50-2;0.01}=2.4066\); \(t_{50-2;0.001}=3.2689\)
Siccome \(2.4066<t_\text{obs}=2.4579<3.2689\), quindi rifiuto \(H_0\) all’1%,
\(0.001<p_\text{value}<0.01\), molto significativo \(\fbox{**}\).
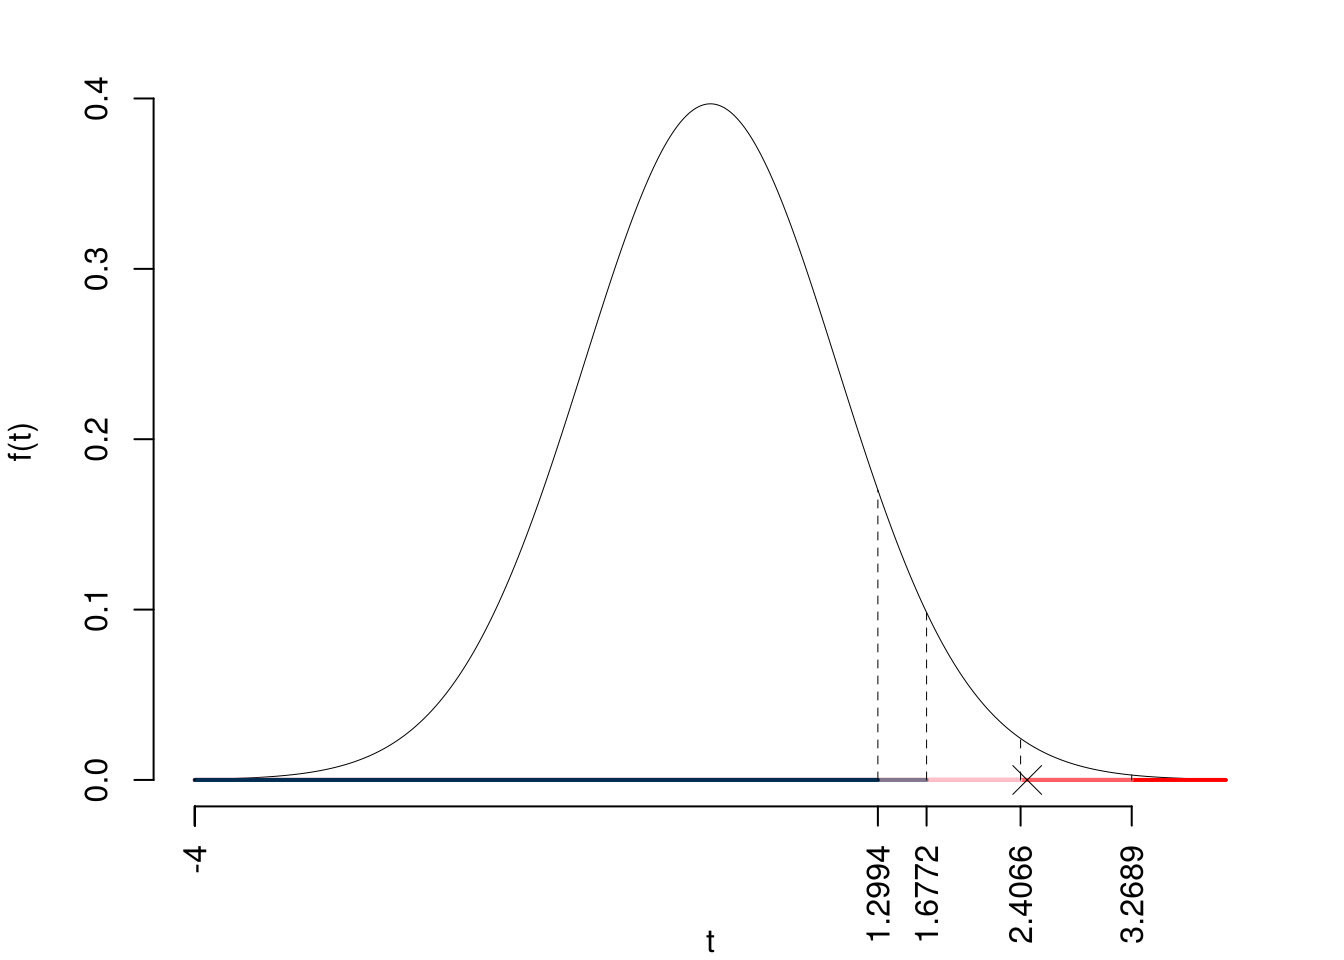
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(T_{50-2}>2.46)=0.008819 \]
Attenzione il calcolo del \(p_\text{value}\) con la \(T\) è puramente illustrativo e non può essere riprodotto senza una calcolatrice statistica adeguata.\[ 0.001 < p_\text{value}= 0.008819 \leq 0.01 \]
5.d (Punti 2/103 \(\rightarrow\) 0.6/31) Che differenza c’è tra interpolazione ed estrapolazione?
5.e (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione \(\hat\beta_1 <0\) che segno avrà \(r\)?
5.f (Punti 2/103 \(\rightarrow\) 0.6/31) Cosa significa dire che \(r^2\) è invariante ai cambiamenti di scala?
Significa che se \(V=a+bY\) e \(W=c+dX\) allora \(r^2_{VW}=r^2_{XY}\).
Prova di Statistica 2026/06/12-3
Esercizio 1
Su un campione di \(200\) aziende con più di 50 addetti dell’Emilia-Romagna è stato rilevato l’investimento effettuato negli ultimi 5 anni in intelligenza artificiale (espresso in milioni di euro). Di seguito è riportata la distribuzione delle frequenze cumulate:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(F_j\) |
|---|---|---|
| 0 | 2 | 0.10 |
| 2 | 3 | 0.50 |
| 3 | 7 | 0.95 |
| 7 | 15 | 1.00 |
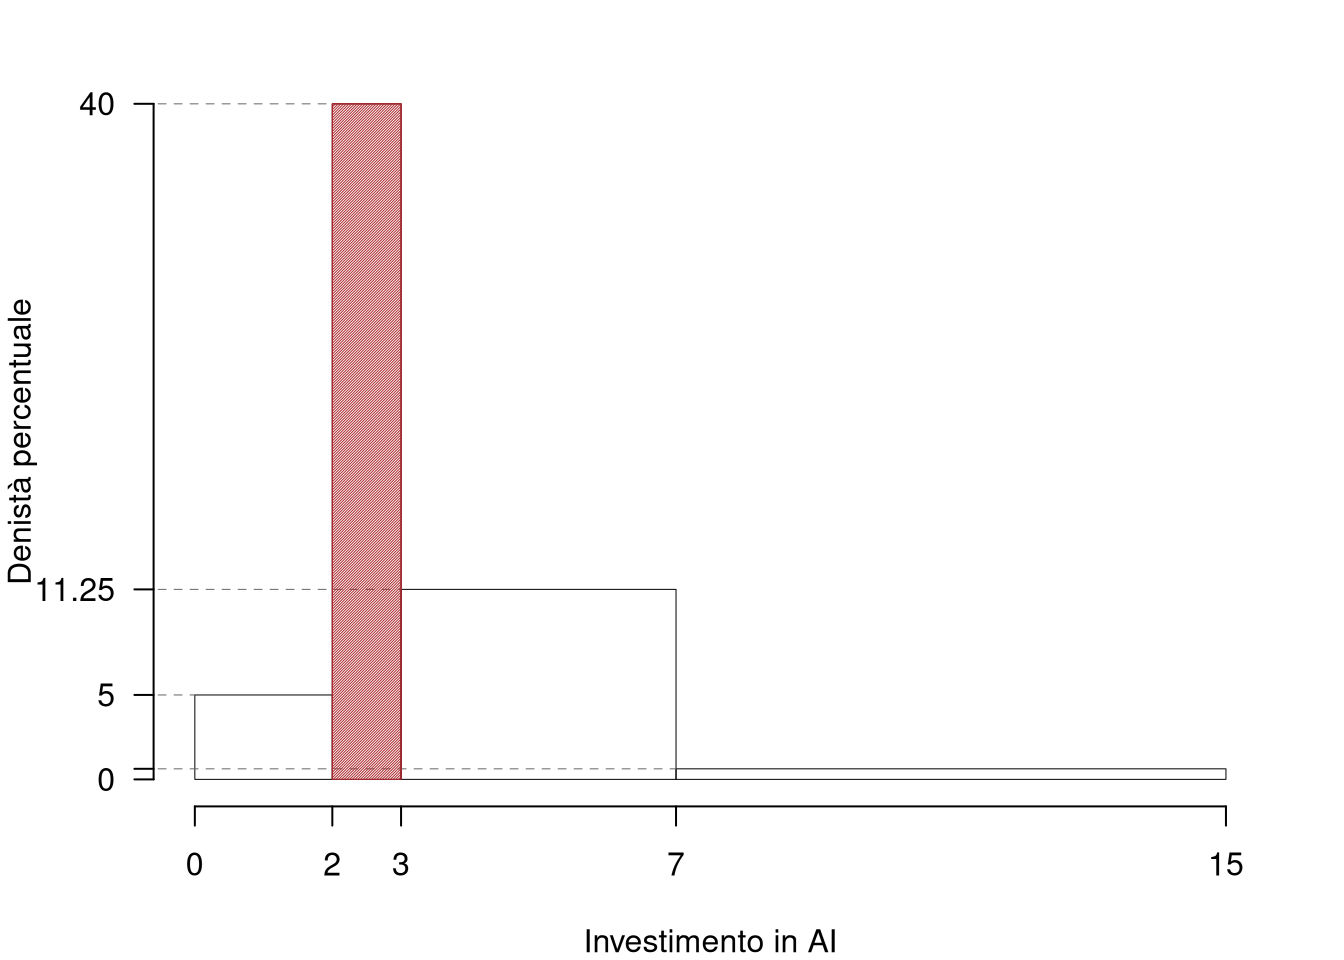
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Individuare la classe modale.
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 2 | 20 | 0.10 | 2 | 5.00 |
| 2 | 3 | 80 | 0.40 | 1 | 40.00 |
| 3 | 7 | 90 | 0.45 | 4 | 11.25 |
| 7 | 15 | 10 | 0.05 | 8 | 0.62 |
| 200 | 1.00 | 15 |
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero approssimativo di aziende che hanno investito tra il 15-esimo e il 25-esimo percentile?
Per definizione \(\%(x_{0.15}<X<x_{0.25})=10\%\) e \(\#(x_{0.15}<X<x_{0.25})\approx0.1\times200 =20\)
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Sapendo che le media è pari a \(3.9\) e considerata la mediana calcolata al punto 1.a, che forma avrà l’istogramma di densità?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) L’investimento medio è pari a \(\bar x=3.9\), mentre la SD è pari a \(\sigma=2.2\). Se ogni impresa aumentasse il proprio investimento del 10%, quanto varrebbero la media e la SD dei dati così trasformati?
\[ \bar y= 4.29 ~~~~~~~~ \sigma_Y= 2.42 \]
Esercizio 2
Un processo è svolto da \(n=5\) agenti AI, ogni agente commette un’allucinazione con probabilità \(\pi=0.25\). Sia \(X_i\) la VC che vale 1 se l’agente \(i\) ha commesso un’allucinazione e vale 0 altrimenti: \[ P(X_i = 1) = 0.25, \qquad i =1,...,5 \] e sia \[ X=X_1+...+X_5 \] la VC che conta il numero di allucinazioni su 5 agenti.
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che il processo abbia al massimo un’allucinazione (\(P(X\le 1)\)).
\[ X=X_1 + ... + X_5 \sim \operatorname{Binom}(5;0.25) \] \[\begin{eqnarray*} P( X \leq 1 ) &=& \binom{ 5 }{ 0 } 0.25 ^{ 0 }(1- 0.25 )^{ 5 - 0 }+\binom{ 5 }{ 1 } 0.25 ^{ 1 }(1- 0.25 )^{ 5 - 1 } \\ &=& 0.2373+0.3955 \\ &=& 0.6328 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) Calcolare \(P(X\le 1|X\le 2)\).
\[ X=X_1 + ... + X_5 \sim \operatorname{Binom}(5;0.25) \]
\[\begin{eqnarray*} P(X\le 1|X\le 2) &=& \frac{P(X\le 1\cap X\le 2)}{P(X\le 2)}\\ &=& \frac{P(X\le 1)}{P(X\le 2)}\\ &=& \frac{0.6328}{0.8965}\\ &=& 0.7059 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(Z\sim N(0,1)\), \(X\sim \chi^2_2\) e \(Y\sim \chi^2_5\), \(X\), \(Y\) e \(Z\) indipendenti. Come si distribuisce \[ \frac{Z}{\sqrt{(X+Y)/7}}\sim~~? \]
\[ X+Y \sim \chi^2_{2+5} \] e quindi \[ \frac{Z}{\sqrt{(X+Y)/7}}\sim t_7 \]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\) e \(B\) due eventi tali che \(P(B)=0.5\) e \(P(A)=0.6\), \(A\) e \(B\) possono essere incompatibili? Perché?
No, perché se lo fossero avremmo che \(P(A\cap B)=0\) e di conseguenza \[ P(A\cup B)= P(A)+P(B)=0.5+0.6> 1 \] che è impossibile.
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 pallina numerata con \(\fbox{0}\), 3 numerate con \(\fbox{1}\) e 1 numerata con \(\fbox{2}\). Si estrae 80 volte con reinserimento. Qual è la probabilità che la somma delle 80 palline sia inferiore a 75?
\[\begin{eqnarray*} \mu &=& \frac 1{ 5 }( 0 + 1 + 1 + 1 + 2 )= 1 \\ \sigma^2 &=& \frac 1{ 5 }( 0 ^2+ 1 ^2+ 1 ^2+ 1 ^2+ 2 ^2 )-( 1 )^2= 0.4 \end{eqnarray*}\] Teorema del Limite Centrale (somma VC qualunque)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(E(X_i)=\mu=1\) e \(V(X_i)=\sigma^2=0.4,\forall i\), posto: \[ S_n = X_1 + ... + X_n \] allora:\[\begin{eqnarray*} S_n & \mathop{\sim}\limits_{a}& N(n\mu,n\sigma^2) \\ &\sim & N(80\cdot1,80\cdot0.4) \\ &\sim & N(80,32) \end{eqnarray*}\]\[\begin{eqnarray*} P( S_n < 75 ) &=& P\left( \frac { S_n - n\mu }{ \sqrt{n\sigma^2} } < \frac { 75 - 80 }{\sqrt{ 32 }} \right) \\ &=& P\left( Z < -0.88 \right) \\ &=& 1-\Phi( 0.88 ) \\ &=& 0.1894 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\beta_0\), \(\hat\beta_1\) e \(\hat\sigma_\varepsilon\) gli stimatori di massima verosimiglianza di, \(\beta_0\), \(\beta_1\) e \(\sigma_\varepsilon\), del modello di regressione lineare semplice \[ y_i = \beta_0 + \beta_1 x_i +\varepsilon_i, ~\varepsilon_i\sim N(0,\sigma^2_\varepsilon),\forall i=1,...,n \] Sapendo che: \[ V(\hat\sigma_\varepsilon)=\frac{2(n-2)}{n^2}\sigma_\varepsilon^4 \] Dimostrare la consistenza di \(\hat\sigma_\varepsilon^2\).
Sappiamo che \(\hat\sigma_\varepsilon^2\) non è stimatore corretto di \(\sigma_\varepsilon^2\) \[ E(\hat\sigma_\varepsilon^2)=\frac{n}{n-2} \sigma_\varepsilon^2 \] ma è corretto asintoticamente \[ \lim_{n\to \infty} E(\hat\sigma_\varepsilon^2)=\lim_{n\to \infty}\frac{n}{n-2} \sigma_\varepsilon^2=\sigma_\varepsilon^2 \] E quindi \[ \lim_{n\to \infty} B^2(\hat\sigma_\varepsilon^2)=\lim_{n\to \infty} (\hat\sigma_\varepsilon^2-\sigma_\varepsilon^2)^2 = 0 \] e siccome \[ \lim_{n\to \infty} V(\hat\sigma_\varepsilon^2)=\frac{2(n-2)}{n^2}\sigma_\varepsilon^4=0 \] allora \[\begin{eqnarray} \lim_{n\to \infty}MSE(\hat\sigma_\varepsilon^2) &=& \lim_{n\to \infty}V(\hat\sigma_\varepsilon^2)+B^2(\hat\sigma_\varepsilon^2)\\ &=& 0 + 0 = 0 \end{eqnarray}\] e quindi \(\hat\sigma_\varepsilon^2\) è stimatore consistente di \(\sigma_\varepsilon^2\).
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Sia \(\hat\theta\) lo stimatore di massima verosimiglianza per \(\theta\), indicare la sua distribuzione asintotica.
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Definire un intervallo di confidenza al 95% per un generico parametro \(\theta\).
Un intervallo di confidenza al livello 95% per \(\theta\) è un intervallo costruito sui dati in modo tale che il 95% delle volte contenga il vero parametro \(\theta\). Ovvero è una coppia di statistiche \(L_1(X_1,...,X_n)<L_2(X_1,...,X_n)\) tali che \[ P([L_1(X_1,...,X_n),L_2(X_1,...,X_n)]\ni\theta)=0.95 \]
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) Una moneta, che non sappiamo se è perfetta oppure no, viene lanciata 100 volte. Abbiamo osservato 34 volte testa su 100 lanci. Posto \(\pi\) la probabilità che la moneta mostri testa, si è testato \[ \begin{cases} H_0:\pi=\frac 12\\ H_1:\pi\ne\frac 12 \end{cases} \] ed è risultato \(p_\text{value}=0.0014\). Possiamo concludere che la moneta sia truccata? Perché?
Esercizio 5
In un’indagine sulla penetrazione dell’intelligenza artificiale (IA) nel mondo del lavoro sono state indagate 75 aziende con oltre i 50 dipendenti della regione Lombardia. L’indagine ha mostrato che 45 aziende su 75 hanno integrato i loro processi produttivi con sistemi IA.
5.a (Punti 3/103 \(\rightarrow\) 0.9/31) Costruire un intervallo di confidenza al 95 % per la proporzione di aziende che in Lombardia integrano i loro processi con l’IA.
\(1-\alpha =0.95\) e quindi \(\alpha=0.05\rightarrow \alpha/2=0.025\)
\[ \hat\pi = \frac{S_n}n = \frac{ 45 }{ 75 }= 0.6 \]
\[\begin{eqnarray*} Idc: & & \hat\pi \pm z_{\alpha/2} \times \sqrt{\frac{\hat\pi(1-\hat\pi)}{n}} \\ & & 0.6 \pm 1.96 \times \sqrt{\frac{ 0.6 (1- 0.6 )}{ 75 }} \\ & & 0.6 \pm 1.96 \times 0.05657 \\ & & [ 0.4891 , 0.7109 ] \end{eqnarray*}\]
5.b (Punti 10/103 \(\rightarrow\) 3/31) Un’indagine analoga, condotta sul territorio nazionale, ha mostrato che la proporzione di aziende che integrano l’IA nei loro processi è pari 0.55. Testare l’ipotesi che la proporzione di aziende che usano le IA nella regione Lombardia sia uguale a quella del resto d’Italia contro l’alternativa che sia maggiore. Risolvere con il \(p_\text{value}\) e confrontarlo per \(\alpha = 0.1,\ 0.05,\ 0.01,\ 0.001\).
Test \(Z\) per una proporzione
La stima \[\hat\pi=\frac { 45 } { 75 }= 0.6 \]
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \pi = \pi_0=0.55 \\ H_1: \pi > \pi_0=0.55 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(Z\) Test Binomiale per \(n\) grande: \(\Rightarrow\) z-Test.
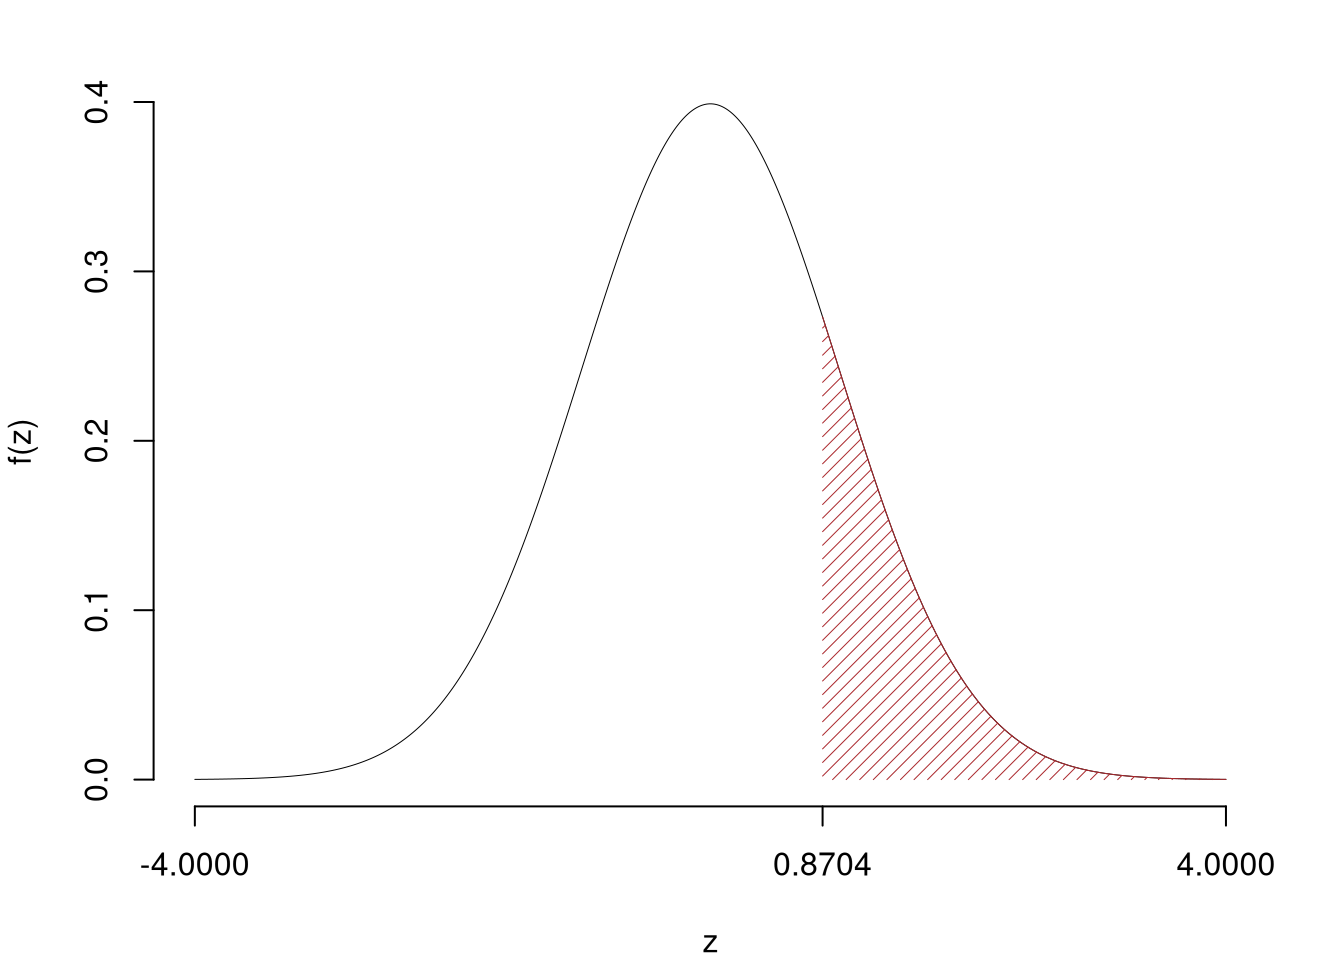
\[\begin{eqnarray*} \frac{\hat\pi - \pi_{0}} {\sqrt {\pi_0(1-\pi_0)/\,n}}&\sim&N(0,1)\\ z_{\text{obs}} &=& \frac{ ( 0.6 - 0.55 )} {\sqrt{ 0.55 (1- 0.55 )/ 75 }} = 0.8704 \,. \end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(Z>0.87)=0.192044 \]
\[
0.1 < p_\text{value}= 0.192044 \leq 1
\]
Non rifiuto \(H_0\) a nessun livello di significatività,
\(p_\text{value}>0.1\), non significativo
Esercizio 6
In uno studio su \(n=50\) municipalità dell’Unione Europea, sono stati analizzati il numero di centraline per la ricarica delle auto elettriche per chilometro quadrato (X) e una misura della qualità dell’aria espressa in opportuna scala (Y).
Si sono osservate le seguenti statistiche: \[\begin{align*} \sum_{i=1}^n x_i &= 497.7, &\sum_{i=1}^n x_i^2 &= 5123.67 & \\ \sum_{i=1}^n y_i &= 113.92, &\sum_{i=1}^n y_i^2 &= 262.03 &\sum_{i=1}^n x_iy_i &= 1151.85. \end{align*}\]
6.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per la regione \(R\) si è osservato \(x_R=10.1\) e \(y_R=2.24\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per la regione \(R\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 497.7 = 9.954 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 113.92 = 2.278 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5124 - 9.954 ^2= 3.391 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 262 - 2.2784 ^2= 0.04949 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 1152 - 9.954 \cdot 2.2784 = 0.3578 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ 0.3578 }{ 3.391 } = 0.1055 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 2.278 - 0.1055 \times 9.954 = 1.228 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 1.228 + 0.1055 \times 10.1 = 2.294 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 2.238 - 2.2938 = -0.05583 \end{eqnarray*}\]
6.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ 0.3578 }{ 1.842 \times 0.2225 }= 0.8733 \\ r^2&=& 0.7627 > 0.75 \end{eqnarray*}\]
Il modello si adatta bene ai dati.
Il modello spiega il \(76.27\%\) della variabilità totale della \(Y\).
6.c (Punti 2/103 \(\rightarrow\) 0.6/31) Definire gli outliers e i punti di leva.
6.d (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione \(\hat\beta_1 >0\) che segno avrà \(r\)?
6.e (Punti 2/103 \(\rightarrow\) 0.6/31) Cosa significa quando \(r^2=0\)?
Prova di Statistica 2026/07/10-1
Esercizio 1
Su un campione di \(200\) blocchi d’ordine merce evasi da un grande polo logistico è stato rilevato il tempo di evasione dell’ordine (espresso in ore). Di seguito è riportata la distribuzione delle frequenze percentuali:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(f_{j\%}\) |
|---|---|---|
| 0 | 6 | 65 |
| 6 | 12 | 25 |
| 12 | 24 | 5 |
| 24 | 48 | 5 |
| 100 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Disegnare l’istogramma di densità percentuale.
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 6 | 130 | 0.65 | 6 | 10.83 |
| 6 | 12 | 50 | 0.25 | 6 | 4.17 |
| 12 | 24 | 10 | 0.05 | 12 | 0.42 |
| 24 | 48 | 10 | 0.05 | 24 | 0.21 |
| 200 | 1.00 | 48 |
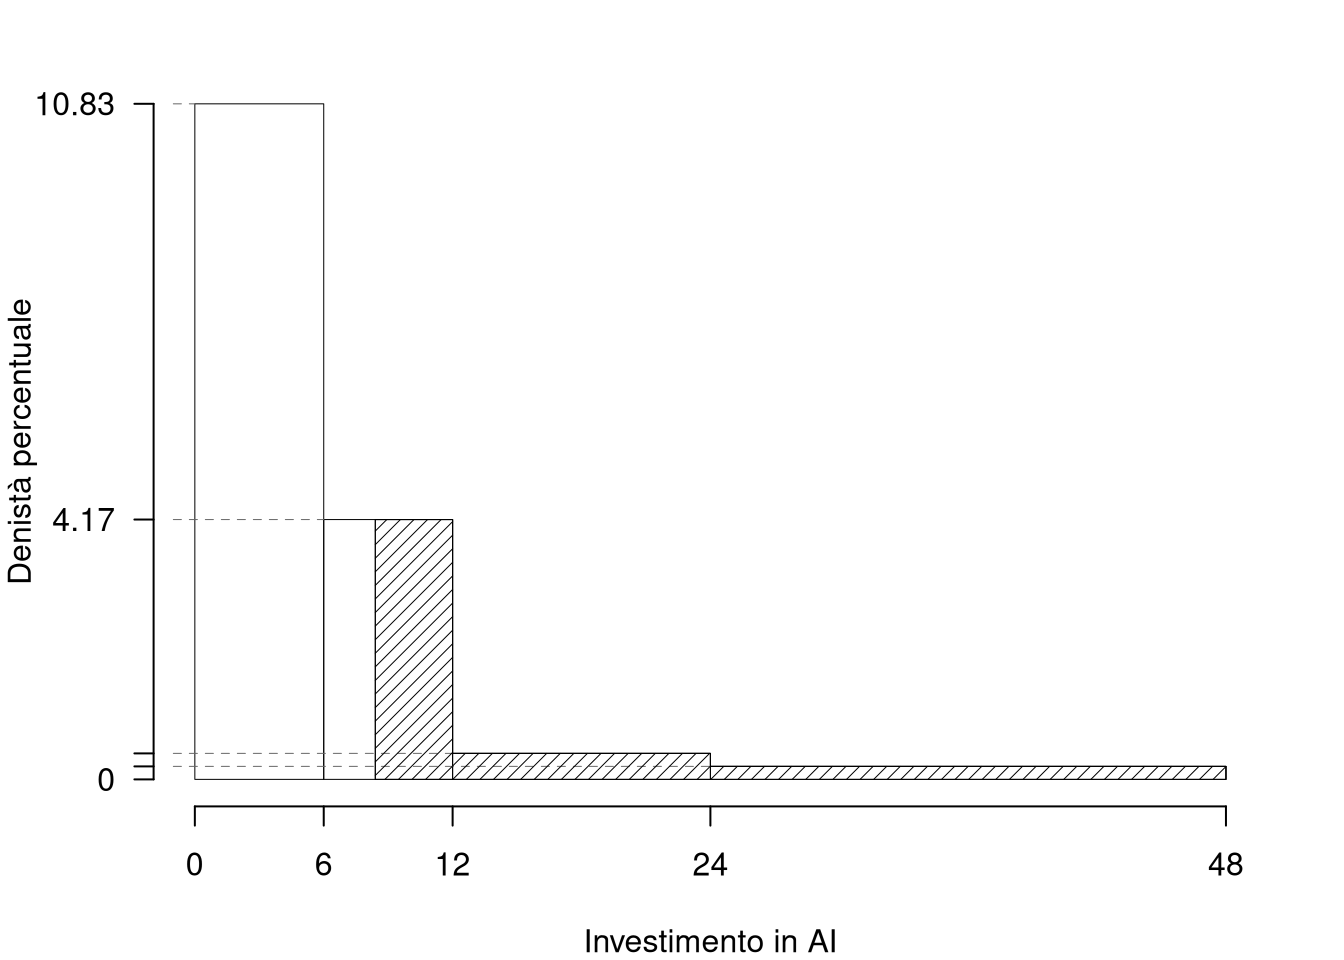
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero di blocchi che hanno impiegato più di 8 ore?
\[\begin{eqnarray*} \%(X> 8 ) &=& ( 12 - 8 )\times h_{ 2 }+ f_{ 3 }\times 100+f_{ 4 }\times 100 \\ &=& ( 4 )\times 4.167 + ( 0.05 )\times 100+( 0.05 )\times 100 \\ &=& 0.2667 \times(100)\\ \#(X> 8 ) &\approx& 53 \end{eqnarray*}\]
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Che relazione dobbiamo aspettarci tra media, mediana e moda?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(x_1,...,x_n\), \(n\) dati quantitativi con media e varianza pari a \(\bar x = 4\) e \(\sigma_X^2=4\). Posto \[ y_i= -\frac 12 x_i, \forall i=1,...,n \] calcolare \(\bar y\) e \(\sigma^2_Y\), la media e la varianza dei dati così trasformati
\[\begin{eqnarray} \bar y &=& -\frac12\bar x= -2\\ \sigma_Y^2 &=& \left(-\frac12\right)^2\sigma_X^2=1 \end{eqnarray}\]
Esercizio 2
Il Security Operations Center (SOC) di un’infrastruttura aziendale cloud monitora costantemente i tentativi di accesso anomali. Il sistema si avvale di due filtri di rilevamento automatici e indipendenti, \(A\) e \(B\).
Il numero di falsi allarmi generati quotidianamente dal filtro \(A\) segue una distribuzione di Poisson con media \(\lambda_A = 0.06\) (\(X_A \sim \text{Pois}(0.06)\)). Il numero di falsi allarmi generati dal filtro \(B\) segue una distribuzione di Poisson con media \(\lambda_B = 0.06\) (\(X_B \sim \text{Pois}(0.06)\)). \(X_A\) e \(X_B\) indipendenti.
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che almeno uno dei due filtri produca uno o più falsi positivi (\(X_A \ge 1 \cup X_B \ge 1\)).
\[\begin{eqnarray*} P( X_i \geq 1 ) &=& 1-P( X_i < 1 ) \\ &=& 1-\left( \frac{ 0.06 ^{ 0 }}{ 0 !}e^{- 0.06 } \right)\\ &=& 1-( 0.9418 )\\ &=& 1- 0.9418 \\ &=& 0.0582 \end{eqnarray*}\] \[\begin{eqnarray} P( \{X_A \ge 1\} \cup \{X_B \ge 1\} ) &=& P( \{X_A \ge 1\} )+P( \{X_B \ge 1\} )-P( \{X_A \ge 1\} \cap \{X_B \ge 1\} ) \\ &=& P( \{X_A \ge 1\} )+P( \{X_B \ge 1\} )-P( \{X_A \ge 1\} )\cdot ( \{X_B \ge 1\} ) \\ &=& 0.05824 + 0.05824 - 0.05824 \times 0.05824 \\ &=& 0.1131 \end{eqnarray}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) In fase di sperimentazione si osservano i filtri \(X_A\) e \(X_B\) lavorare per un certo numero di giorni finché non generano almeno un falso positivo. Calcolare la probabilità che l’osservazione duri esattamente 4 giorni.
\[\begin{eqnarray*} P(\{X_A \ge 1\}\cup\{X_B \ge 1\}) &=&0.1131\\ \overline{\{X_A \ge 1\}\cup\{X_B \ge 1\}} &=& \{X_A < 1\}\cap\{X_B < 1\}\\ P(\{X_A < 1\}\cap\{X_B < 1\}) &=&1-0.1131\\ P(n=4) &=& (1-0.1131)^3\cdot 0.1131\\ &=& 0.0789 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Sia \(X\) una \(VC\) con supporto \(S_X=\{-1,0,+1\}\) e \(Y\) una \(VC\) con supporto \(S_Y=\{-1,0,+1\}\), calcolare il supporto di \(X+Y\).
\[ S_{X+Y}=\{-2,-1,0,+1,+2\} \]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\ne\emptyset\) e \(B\ne\emptyset\), tali che \(A\cap B = \emptyset\), \(A\) e \(B\) possono essere indipendenti? Perché?
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Si lancia una moneta perfetta due volte, si vince se escono due teste e si perde altrimenti. Si ripete il gioco per 50 volte, qual è la probabilità di vincere più di 15 volte?
\[ \pi= \frac 12\frac 12 = \frac 14 \] Teorema del Limite Centrale (somma di Bernoulli)
Siano \(X_1\),…,\(X_n\), \(n=50\) VC IID, tc \(X_i\sim\text{Ber}(\pi=0.25)\)\(,\forall i\), posto: \[ S_n = X_1 + ... + X_n \] allora:\[\begin{eqnarray*} S_n & \mathop{\sim}\limits_{a}& N(n\pi,n\pi(1-\pi)) \\ &\sim & N(50\cdot0.25,50\cdot0.25\cdot(1-0.25)) \\ &\sim & N(12.5,9.375) \end{eqnarray*}\]\[\begin{eqnarray*} P( S_n > 15 ) &=& P\left( \frac { S_n - n\pi }{ \sqrt{n\pi(1-\pi)} } > \frac { 15 - 12.5 }{\sqrt{ 9.375 }} \right) \\ &=& P\left( Z > 0.82 \right) \\ &=& 1-P(Z< 0.82 )\\ &=& 1-\Phi( 0.82 ) \\ &=& 0.2061 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(x_1,...,x_n\) \(n\) osservazioni \(IID\), dal modello di Normale \(X_i\sim\text{Ber}(\mu,\sigma^2)\). Scrivere lo stimatore di massima verosimiglianza \(\hat\mu\) per \(\mu\) e mostrare la sua correttezza.
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\theta_1\) e \(\hat\theta_2\) due stimatori corretti per \(\theta\), cosa significa dire che \(\hat\theta_1\) è più efficiente di \(\hat\theta_2\)?
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Si consideri il seguente sistema d’ipotesi: \(H_0:\theta=\theta_0\), \(H_1:\theta<\theta_0\). Posta con \(T\) la VC statistica test e con \(t_\text{obs}\) il valore osservato della statistica test, definire il \(p_\text{value}\) del test.
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) Un dado viene lanciato 100 volte per testare se è regolare oppure no, posto \(\pi_i\) la probabilità di mostrare la faccia \(i=1,...,6\), viene messo a test \(H_0: \pi_i=1/6~\forall i\). Eseguito il test del chi-quadro di conformità si ottine un \(p_\text{value}=0.8523\). Possiamo concludere che il dado è regolare? Perché?
Esercizio 5
Un’azienda produttrice di batterie ha introdotto un nuovo processo produttivo nello stabilimento \(A\). Per valutare la durata delle batterie sono stati testati 24 esemplari, ottenendo una durata media pari a \(\hat\mu_A=815\) cicli di ricarica e una deviazione standard campionaria \(\hat\sigma_A=42\).
5.a (Punti 3/103 \(\rightarrow\) 0.9/31) Costruire un intervallo di confidenza al 95% per la durata media delle batterie prodotte nello stabilimento \(A\).
\(1-\alpha =0.95\) e quindi \(\alpha=0.05\rightarrow \alpha/2=0.025\)
\[ S =\sqrt{\frac {n}{n-1}}\cdot\hat\sigma = \sqrt{\frac { 24 }{ 23 }}\cdot 42 = 42.9033 \] \[\begin{eqnarray*} Idc: & & \hat\mu \pm t_{n-1;\alpha/2} \times \frac{S}{\sqrt{n}} \\ & & 815 \pm 2.069 \times \frac{ 42.9033 }{\sqrt{ 24 }} \\ & & 815 \pm 2.069 \times 8.758 \\ & & [ 796.9 , 833.1 ] \end{eqnarray*}\]
5.b (Punti 10/103 \(\rightarrow\) 3/31) Lo stesso test è stato effettuato nello stabilimento \(B\). Sono state esaminate 20 batterie, ottenendo una durata media pari a \(\hat\mu_B=788\) cicli e una deviazione standard campionaria \(\hat\sigma_B=39\).
Assumendo l’uguaglianza delle varianze delle due popolazioni, testare l’ipotesi che le durate medie dei due stabilimenti siano uguali contro l’alternativa che siano diverse, per \(\alpha=0.1,0.05,0.01,0.001\), e fornire una valutazione approssimativa del \(p\)-value (ad esempio: minore di 0.001, compreso tra 0.01 e 0.05, ecc.).
Test \(T\) per due medie, (omogeneità)
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \mu_\text{A} = \mu_\text{B} \\ H_1: \mu_\text{A} \neq \mu_\text{B} \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(T\)
L’ipotesi è di omogeneità e quindi calcoliamo:\[ S_p^2=\frac{n_\text{ A }\hat\sigma^2_\text{ A }+n_\text{ B }\hat\sigma^2_\text{ B }}{n_\text{ A }+n_\text{ B }-2} = \frac{ 24 \cdot 42 ^2+ 20 \cdot 39 ^2}{ 24 + 20 -2}= 1732 \]
\[\begin{eqnarray*} \frac{\hat\mu_\text{ A } - \hat\mu_\text{ B }} {\sqrt{\frac {S^2_p}{n_\text{ A }}+\frac {S^2_p}{n_\text{ B }}}}&\sim&t_{n_\text{ A }+n_\text{ B }-2}\\ t_{\text{obs}} &=& \frac{ ( 815 - 788 )} {\sqrt{\frac{ 1732 }{ 24 }+\frac{ 1732 }{ 20 }}} = 2.143 \, . \end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Siccome \(H_1\) è bilaterale, considereremo \(\alpha/2\), anziché \(\alpha\)
\(\alpha=0.1, 0.05, 0.01, 0.001\) e quindi \(\alpha/2=0.05, 0.025, 0.005, 0.0005\)
I valori critici sono
\(t_{44-2;0.05}=1.682\); \(t_{44-2;0.025}=2.0181\); \(t_{44-2;0.005}=2.6981\); \(t_{44-2;0.0005}=3.5377\)
Siccome \(2.0181<|t_\text{obs}|=2.1426<2.6981\), quindi rifiuto \(H_0\) al 5%,
\(0.01<p_\text{value}<0.05\), significativo \(\fbox{*}\).
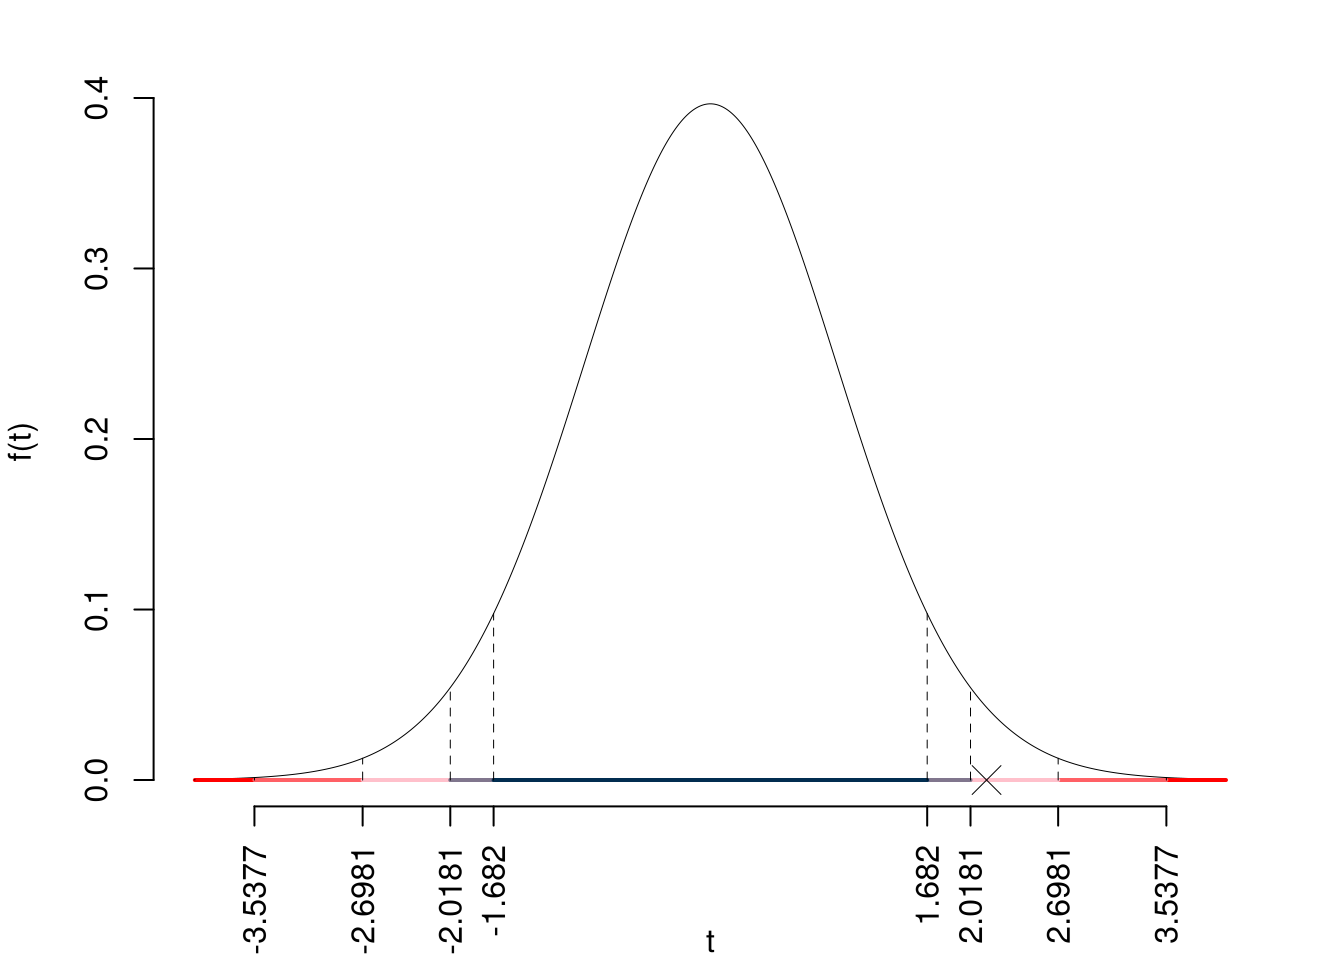
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(|T_{44-2}|>|2.14|)=2P(T_{44-2}>2.14)=0.037983 \]
Attenzione il calcolo del \(p_\text{value}\) con la \(T\) è puramente illustrativo e non può essere riprodotto senza una calcolatrice statistica adeguata.\[ 0.01 < p_\text{value}= 0.037983 \leq 0.05 \]
Esercizio 6
In uno studio su \(n=150\) municipalità dell’Unione Europea, sono stati analizzati la percentuale di edifici residenziali dotati di isolamento termico ad alta efficienza (\(X\)) e il consumo medio annuo di energia pro capite per il riscaldamento domestico (in MWh, \(Y\)).
Si sono osservate le seguenti statistiche: \(\sum_{i=1}^n x_i = 1495.3\), \(\sum_{i=1}^n x_i^2 = 15056.97\), \(\sum_{i=1}^n y_i = 3881.31\), \(\sum_{i=1}^n y_i^2 = 107920.11\), \(\sum_{i=1}^n x_iy_i = 37745.69.\)
6.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per la regione \(R\) si è osservato \(x_R=10.6\) e \(y_R=22.19\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per la regione \(R\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 150 } 1495.3 = 9.969 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 150 } 3881.31 = 25.88 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 150 } 15057 - 9.9687 ^2= 1.005 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 150 } 107920 - 25.8754 ^2= 49.93 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 150 } 37746 - 9.9687 \cdot 25.8754 = -6.305 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ -6.305 }{ 1.005 } = -6.271 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 25.88 - (-6.2709) \times 9.9687 = 88.39 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 88.39 + (-6.2709) \times 10.6 = 21.92 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 22.19 - 21.9164 = 0.2741 \end{eqnarray*}\]
6.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ -6.305 }{ 1.003 \times 7.066 }= -0.8899 \\ r^2&=& 0.7919 > 0.75 \end{eqnarray*}\]
Il modello si adatta bene ai dati.
Il modello spiega il \(79.19\%\) della variabilità totale della \(Y\).
6.c (Punti 2/103 \(\rightarrow\) 0.6/31) Interpretare il diagramma dei residui: sono violati alcuni assunti del modello? Se sì, quali?
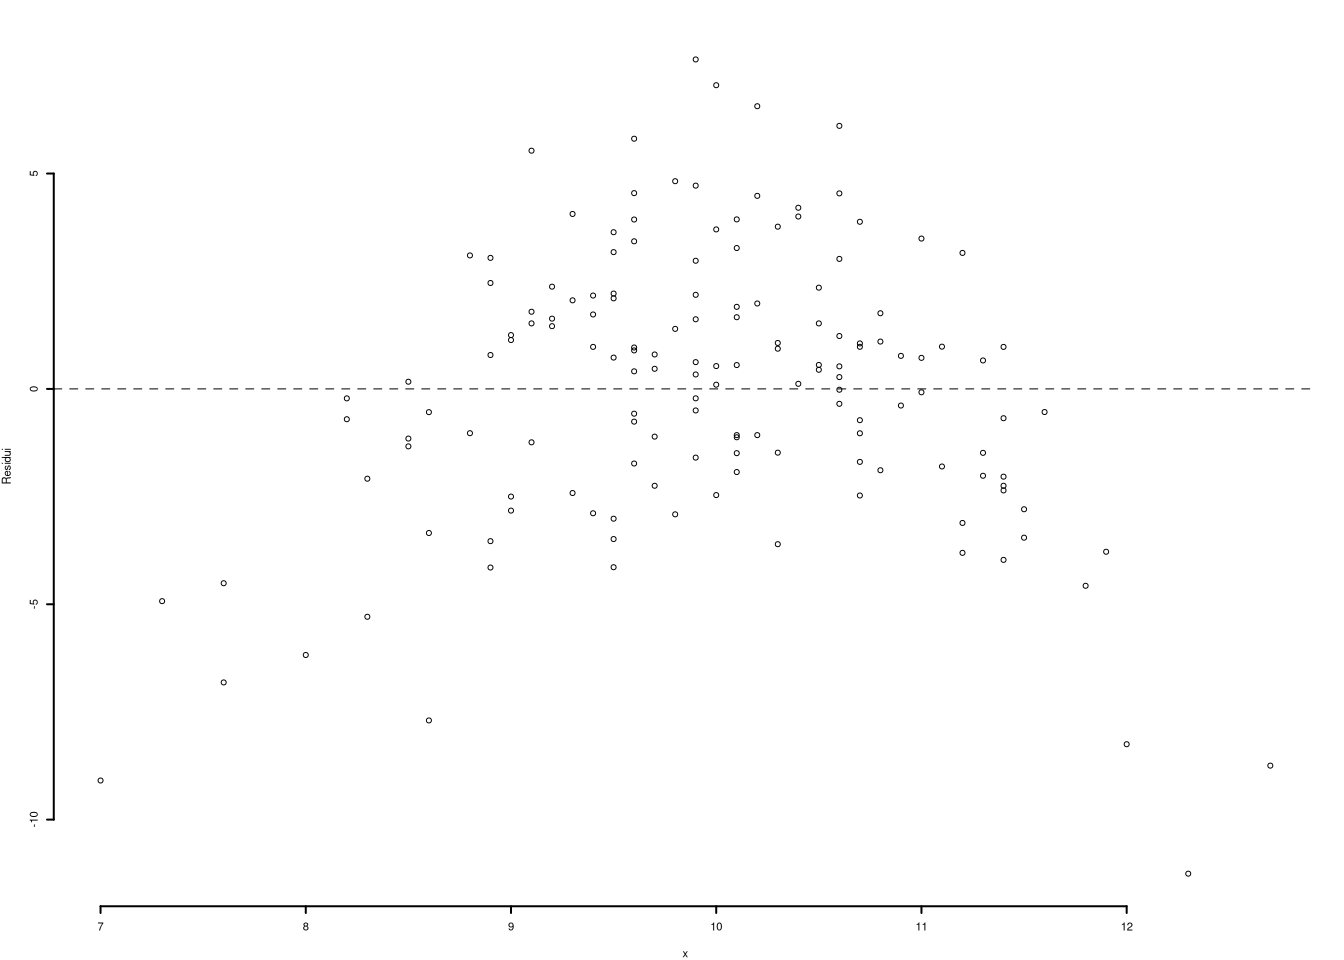
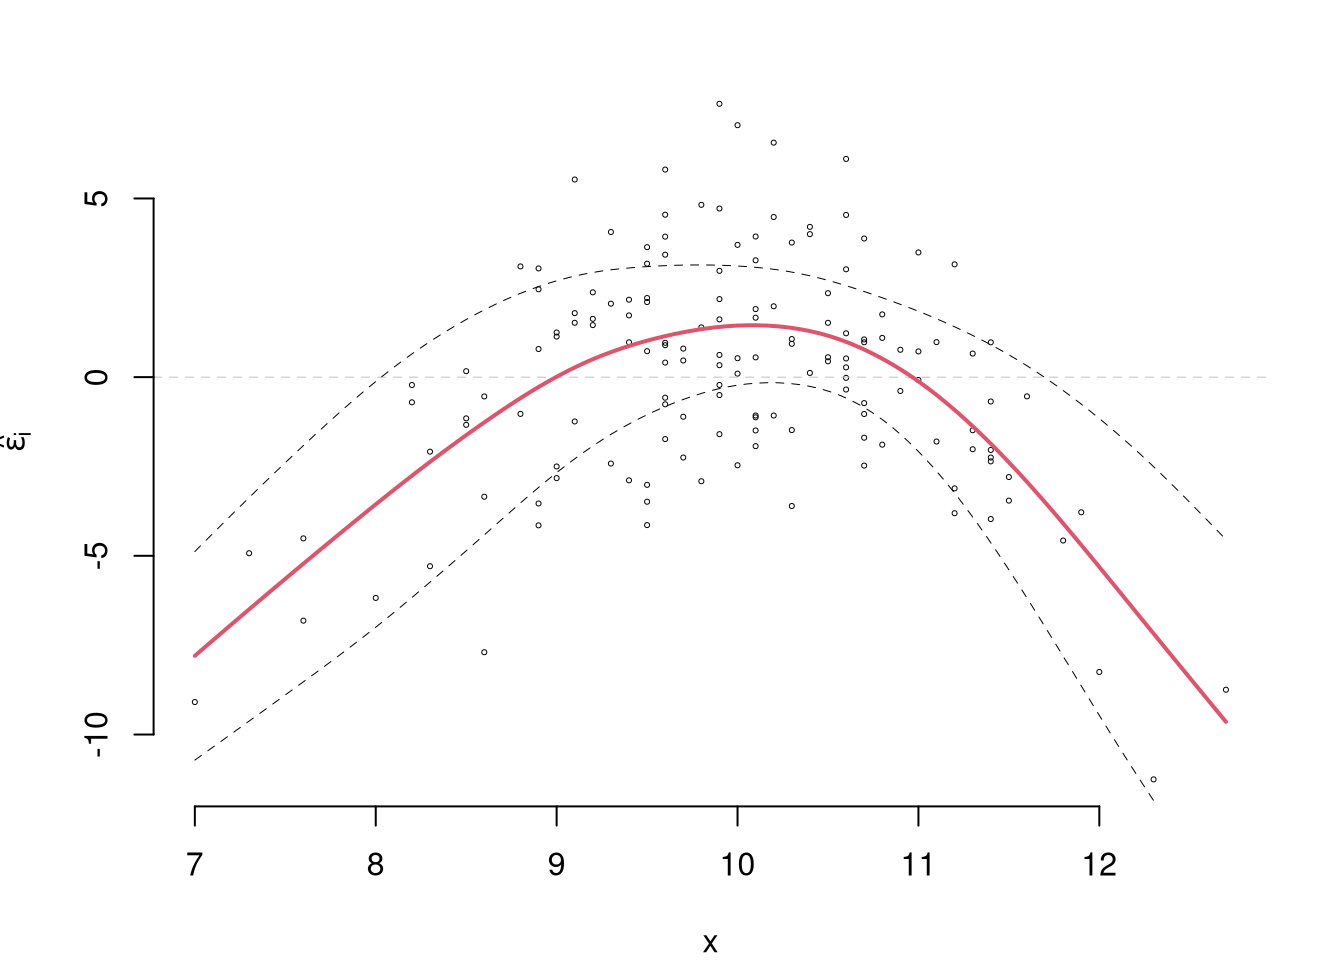
6.d (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione lineare \(\hat\beta_1 =0\) quanto vale \(r\)?
6.e (Punti 2/103 \(\rightarrow\) 0.6/31) In un modello di regressione lineare, cosa comporta \(r^2=(-1)^2\)?
Prova di Statistica 2026/07/10-2
Esercizio 1
Su un campione di \(200\) blocchi d’ordine merce evasi da un grande polo logistico è stato rilevato il tempo di evasione dell’ordine (espresso in ore). Di seguito è riportata la distribuzione delle densità percentuali:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(h_j\) |
|---|---|---|
| 0 | 6 | 1.667 |
| 6 | 8 | 10.000 |
| 8 | 9 | 50.000 |
| 9 | 10 | 20.000 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare il valore approssimativo della mediana.
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 6 | 20 | 0.1 | 6 | 1.67 |
| 6 | 8 | 40 | 0.2 | 2 | 10.00 |
| 8 | 9 | 100 | 0.5 | 1 | 50.00 |
| 9 | 10 | 40 | 0.2 | 1 | 20.00 |
| 200 | 1.0 | 10 |
\[\begin{eqnarray*}
p &=& 0.5 , \text{essendo }F_{ 3 }= 0.8 > 0.5 \Rightarrow j_{ 0.5 }= 3 \\
x_{ 0.5 } &=& x_{\text{inf}; 3 } + \frac{ { 0.5 } - F_{ 2 }} {f_{ 3 }} \cdot b_{ 3 } \\
&=& 8 + \frac {{ 0.5 } - 0.3 } { 0.5 } \cdot 1 \\
&=& 8.4
\end{eqnarray*}\]
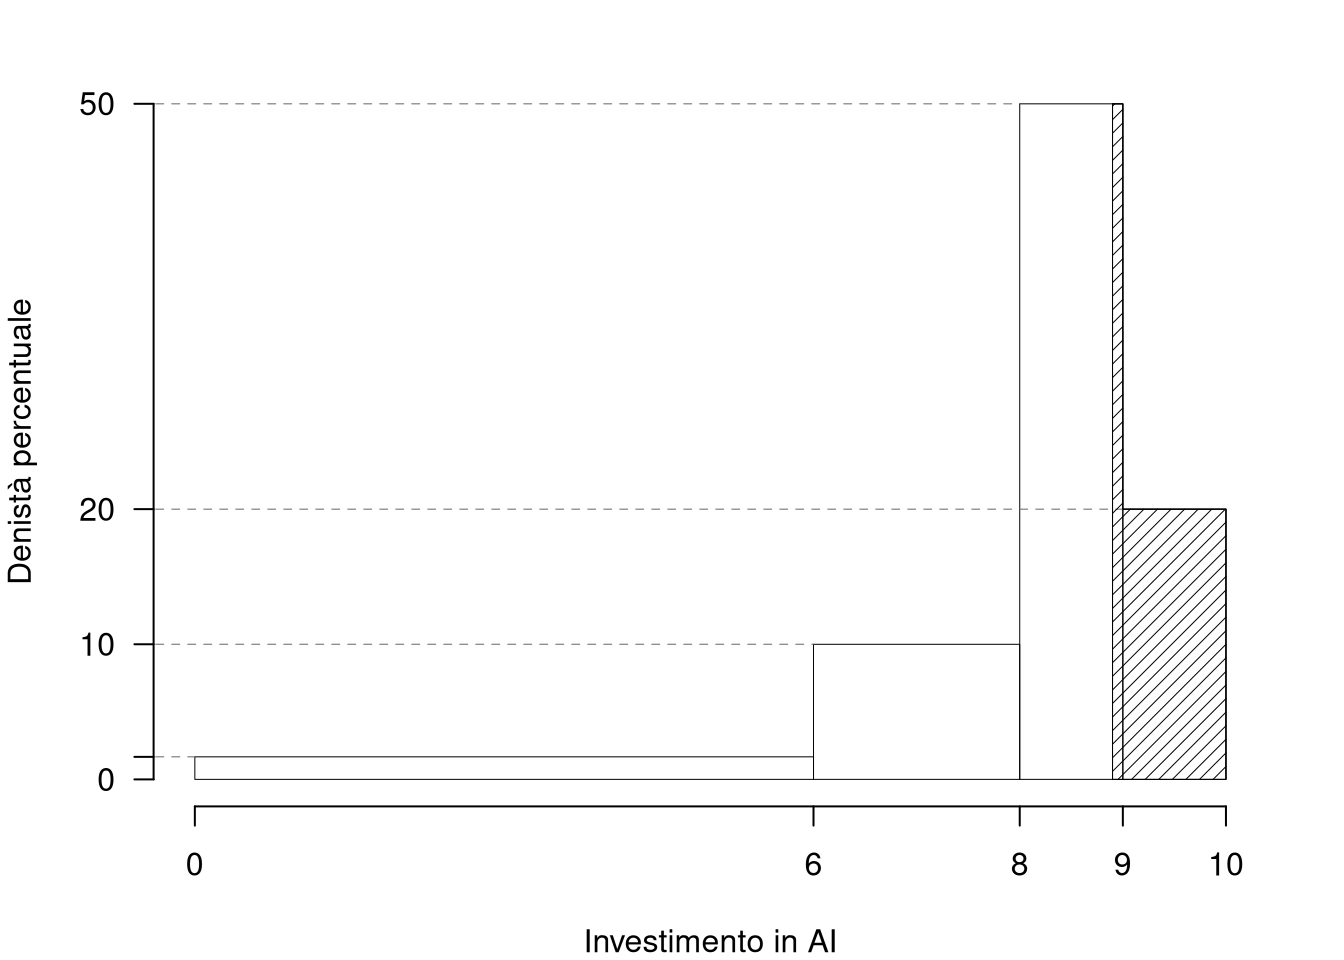
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Qual è il numero approssimativo di blocchi che hanno impiegato più di 8.9 ore?
\[\begin{eqnarray*} \%(X> 8.9 ) &=& ( 9 - 8.9 )\times h_{ 3 }+ f_{ 4 }\times 100 \\ &=& ( 0.1 )\times 50 + ( 0.2 )\times 100 \\ &=& 0.25 \times(100)\\ \#(X> 8.9 ) &\approx& 50 \end{eqnarray*}\]
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Sapendo che le media è pari a \(7.8\) e considerata la mediana calcolata al punto 1.a, che forma avrà l’istogramma di densità?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) Se \(x_1 = x_2 = ... = x_n = k\) sono \(n\) dati tutti uguali tra di loro e pari ad un valore \(k\), quanto vale la media \(\bar x\) e la varianza \(\sigma^2\) di questi dati? Giustificare brevemente la risposta.
Esercizio 2
Ogni minuto due modelli di intelligenza artificiale, \(A\) e \(B\), allocano dinamicamente memoria RAM per elaborare i prompt degli utenti. La quantità di memoria RAM (in GB) occupata istantaneamente dal modello \(A\) segue una distribuzione Normale con media 14 e varianza 5 (\(X_A \sim N(14,5)\)). La memoria occupata dal modello \(B\) segue una distribuzione Normale con media 9 e varianza 4 (\(X_B \sim N(9,4)\)). I due modelli lavorano in ambienti isolati e indipendenti. Il sistema di monitoraggio dell’infrastruttura cloud registra un’anomalia di sbilanciamento se il modello \(A\) occupa almeno 11 GB di RAM in più rispetto al modello \(B\).
2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Calcolare la probabilità che il sistema registri un’anomalia per sbilanciamento della memoria (\(P(X_A - X_B \ge 11)\)).
Sia \(X_D = X_A - X_B\) la variabile differenza. Poiché \(X_A\) e \(X_B\) sono Normali e indipendenti:
\[X_D \sim N(14 - 9, 5 + 4) \implies D \sim N(5, 9)\]
con deviazione standard \(\sigma_D = \sqrt{9} = 3\).
\[\begin{eqnarray*} P( X_D > 11 ) &=& P\left( \frac { X_D - \mu_D }{ \sigma_D } > \frac { 11 - 5 }{\sqrt{ 9 }} \right) \\ &=& P\left( Z > 2 \right) \\ &=& 1-P(Z< 2 )\\ &=& 1-\Phi( 2 ) \\ &=& 0.0228 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) Assumendo che le allocazioni nei diversi minuti siano indipendenti, calcolare la probabilità che si registri almeno un’anomalia (\(X_A - X_B \ge 11\)) nei primi 10 minuti di lavoro.
Sia:
\[E = \text{"Si registra almeno un'anomalia nei 10 minuti di lavoro"}\]
quindi l’evento complementare espresso in linguaggio naturale è:
\[\bar E = \text{"Non si registra alcuna anomalia in nessuno dei 10 minuti di lavoro"}\]
posto:
\[A_i = \text{"Si registra un'anomalia al minuto } i\text{-esimo"} \quad \text{con } P(A_i) = p = 0.0228, \quad \forall i = 1, \dots, 10\]
allora, per l’indipendenza stocastica delle osservazioni nei singoli minuti, si ha:
\[\begin{eqnarray*} P(\bar E) &=& P(\bar A_1 \cap \bar A_2 \cap \ldots \cap \bar A_{10}) \\ &=& P(\bar A_1) \cdot P(\bar A_2) \cdot \ldots \cdot P(\bar A_{10}) \\ &=& (1 - p)^{10} \\ &=& (1 - 0.0228)^{10} \\ &=& 0.7936 \end{eqnarray*}\]
Da cui si ricava la probabilità dell’evento di interesse: \[\begin{eqnarray*} P(E) &=& 1 - P(\bar E) \\ &=& 1 - 0.7936 \\ &=& 0.2064 \end{eqnarray*}\]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(X_1\sim \text{Binom}(4,0.25)\), \(X_2\sim \text{Binom}(5,0.25)\) e \(X_3\sim \text{Ber}(0.25)\), \(X_1\), \(X_2\) e \(X_3\) indipendenti. Come si distribuisce \(X=X_1+X_2+X_3\)?
\[ X_1+X_2+X_3 \sim \text{Binom}(10,0.5) \]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\ne\emptyset\) e \(B\ne\emptyset\) due eventi, tali che \(P(B|A)=P(B)\), \(A\) e \(B\) possono essere incompatibili? Perché?
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 pallina numerata con \(\fbox{0}\), 2 numerate con \(\fbox{1}\) e 1 numerata con \(\fbox{6}\). Si estrae 80 volte con reinserimento. Qual è la probabilità che la somma delle 80 palline estratte sia maggiore di 150?
\[\begin{eqnarray*} \mu &=& E(X_i) = \sum_{x\in S_X}x P(X=x)\\ &=& 0 \frac { 1 }{ 4 }+ 1 \frac { 2 }{ 4 }+ 6 \frac { 1 }{ 4 } \\ &=& 2 \\ \sigma^2 &=& V(X_i) = \sum_{x\in S_X}x^2 P(X=x)-\mu^2\\ &=&\left( 0 ^2\frac { 1 }{ 4 }+ 1 ^2\frac { 2 }{ 4 }+ 6 ^2\frac { 1 }{ 4 } \right)-( 2 )^2\\ &=& 5.5 \end{eqnarray*}\] Teorema del Limite Centrale (somma VC qualunque)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(E(X_i)=\mu=2\) e \(V(X_i)=\sigma^2=5.5,\forall i\), posto: \[ S_n = X_1 + ... + X_n \] allora:\[\begin{eqnarray*} S_n & \mathop{\sim}\limits_{a}& N(n\mu,n\sigma^2) \\ &\sim & N(80\cdot2,80\cdot5.5) \\ &\sim & N(160,440) \end{eqnarray*}\]\[\begin{eqnarray*} P( S_n > 150 ) &=& P\left( \frac { S_n - n\mu }{ \sqrt{n\sigma^2} } > \frac { 150 - 160 }{\sqrt{ 440 }} \right) \\ &=& P\left( Z > -0.48 \right) \\ &=& 1-P(Z< -0.48 )\\ &=& 1-(1-\Phi( 0.48 )) \\ &=& 0.6844 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(x_1,...,x_n\) \(n\) osservazioni \(IID\), dal modello di Poisson \(X_i\sim\text{Pois}(\lambda)\). Scrivere lo stimatore di massima verosimiglianza \(\hat\lambda\) per \(\lambda\) e mostrare la sua correttezza.
\[ \hat\lambda=\frac 1n \sum_{i=1}^n X_i \] Quindi \[\begin{eqnarray} E(\hat\lambda) &=& E(\frac 1n \sum_{i=1}^n X_i)\\ &=& \frac 1n \sum_{i=1}^nE(X_i)\\ &=& \frac 1n \sum_{i=1}^n\lambda\\ &=& \frac 1n \cdot n \lambda\\ &=& \lambda \end{eqnarray}\]
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(\hat\theta_1\) e \(\hat\theta_2\) due stimatori non corretti per \(\theta\), cosa significa dire che \(\hat\theta_1\) è più efficiente di \(\hat\theta_2\)?
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Si consideri il seguente sistema d’ipotesi: \(H_0:\theta=\theta_0; H_1:\theta\ne \theta_0\). Posta con \(T\) la VC statistica test e con \(t_\text{obs}\) il valore osservato della statistica test, definire il \(p_\text{value}\) del test.
Il \(p_\text{value}\) è la probabilità, se fosse vera \(H_0\) di avere un campione ancora più favorevole ad \(H_1\) di quello che abbiamo osservato, in altre parole ci dice quanto è raro il campione sotto ipotesi \(H_0\). In simboli, nel caso di un test unilaterale destro \[ p_\text{value} = P(|T|>|t_\text{obs}|) \]
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) In un sondaggio su 160 persone stato rilevato il titolo di studio (Diploma, Laurea, Post-laurea) e l’opinione riguardo alla diffusione del lavoro da remoto (Favorevole, Contrario).
| Diploma | Laurea | Post-laurea | Tot | |
|---|---|---|---|---|
| Favorevole | 22 | 28 | 40 | 90 |
| Contrario | 18 | 32 | 20 | 70 |
| Tot | 40 | 60 | 60 | 160 |
Eseguito il test del \(\chi^2\) per verificare l’indipendenza tra il livello di utilizzo degli strumenti di AI e l’opinione sul loro impatto nel mondo del lavoro, si ottiene un \(p_\text{value}=0.08586\). Possiamo concludere che il titolo di studio di utilizzo e l’opinione sullo smart working sono indipendenti? Perché?
Esercizio 5
In uno studio condotto su un campione di \(n = 50\) aziende del settore terziario avanzato, sono state analizzate la quota di budget aziendale destinata a piani di welfare sussidiario e benefit per i dipendenti (espressa in percentuale sul fatturato, \(X\)) e la durata media del rapporto di lavoro del personale in organico (misurata in anni, \(Y\)).
Si sono osservate le seguenti statistiche: \[\begin{align*} \sum_{i=1}^n x_i &= 508.3, &\sum_{i=1}^n x_i^2 &= 5209.95 & \\ \sum_{i=1}^n y_i &= 114.49, &\sum_{i=1}^n y_i^2 &= 262.91 &\sum_{i=1}^n x_iy_i &= 1167.99. \end{align*}\]
5.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per l’azienda \(A\) si è osservato \(x_A=11.1\) e \(y_R=2.43\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per l’azienda \(A\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 508.3 = 10.17 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 114.49 = 2.29 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5210 - 10.166 ^2= 0.8514 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 262.9 - 2.2898 ^2= 0.01502 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 1168 - 10.166 \cdot 2.2898 = 0.08178 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ 0.08178 }{ 0.8514 } = 0.09605 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 2.29 - 0.0961 \times 10.166 = 1.313 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 1.313 + 0.0961 \times 11.1 = 2.38 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 2.433 - 2.3795 = 0.0532 \end{eqnarray*}\]
5.b (Punti 4/103 \(\rightarrow\) 1.2/31) Determinare la percentuale di varianza spiegata dal modello.
\[\begin{eqnarray*} r&=&\frac{\text{cov}(X,Y)}{\sigma_X\sigma_Y}=\frac{ 0.08178 }{ 0.9227 \times 0.1225 }= 0.7233 \\ r^2&=& 0.5231 < 0.75 \end{eqnarray*}\]
Il modello non si adatta bene ai dati.
Il modello spiega il \(52.31\%\) della variabilità totale della \(Y\).
5.c (Punti 13/103 \(\rightarrow\) 3.9/31) Testare l’ipotesi che \(\beta_1 = 0.05\) contro l’alternativa che sia maggiore, per \(\alpha=0.1,0.05,0.01,0.001\) e dare una valutazione approssimativa del \(p_\text{value}\) (ad esempio il \(p_\text{value}\) è minore di 0.001, compreso tra 0.05 e tra 0.01, ecc.).
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \beta_1 = \beta_{1;H_0}=0.05 \\ H_1: \beta_1 > \beta_{1;H_0}=0.05 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(T\) Test su un coefficiente di regressione: \(\Rightarrow\) t-Test.
\[\begin{eqnarray*} \hat{\sigma_\varepsilon}^2&=&(1-r^2)\hat\sigma_Y^2\\ &=& (1- 0.5232 )\times 0.015 \\ &=& 0.0072 \\ S_\varepsilon^2 &=& \frac{n} {n-2} \hat{\sigma_\varepsilon}^2\\ &=& \frac{ 50 } { 50 -2} \hat{\sigma_\varepsilon}^2 \\ &=& \frac{ 50 } { 50 -2} \times 0.0072 = 0.0075 \end{eqnarray*}\]
E quindi\[\begin{eqnarray*} V(\hat\beta_{1}) &=& \frac{\sigma_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ \widehat{V(\hat\beta_{1})} &=& \frac{S_{\varepsilon}^{2}} {n \hat{\sigma}^{2}_{X}} \\ &=& \frac{ 0.0075 } { 50 \times 0.8514 } = 0.0002 \\ \widehat{SE(\hat\beta_{1})} &=& \sqrt{ 0.0002 }\\ &=& 0.01414 \end{eqnarray*}\]
\[\begin{eqnarray*} \frac{\hat\beta_{ 1 } - \beta_{ 1 ;H_0}} {\widehat{SE(\hat\beta_{ 1 })}}&\sim&t_{n-2}\\ t_{\text{obs}} &=& \frac{ ( 0.09605 - 0.05 )} { 0.01324 } = 3.479 \, . \end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Consideriamo \(\alpha=0.1, 0.05, 0.01, 0.001\)
I valori critici sono
\(t_{50-2;0.1}=1.2994\); \(t_{50-2;0.05}=1.6772\); \(t_{50-2;0.01}=2.4066\); \(t_{50-2;0.001}=3.2689\)
Siccome \(t_\text{obs}=3.4792>3.2689\), quindi rifiuto \(H_0\) sotto all’1‰,
\(p_\text{value}<0.001\), estremamente significativo \(\fbox{***}\).
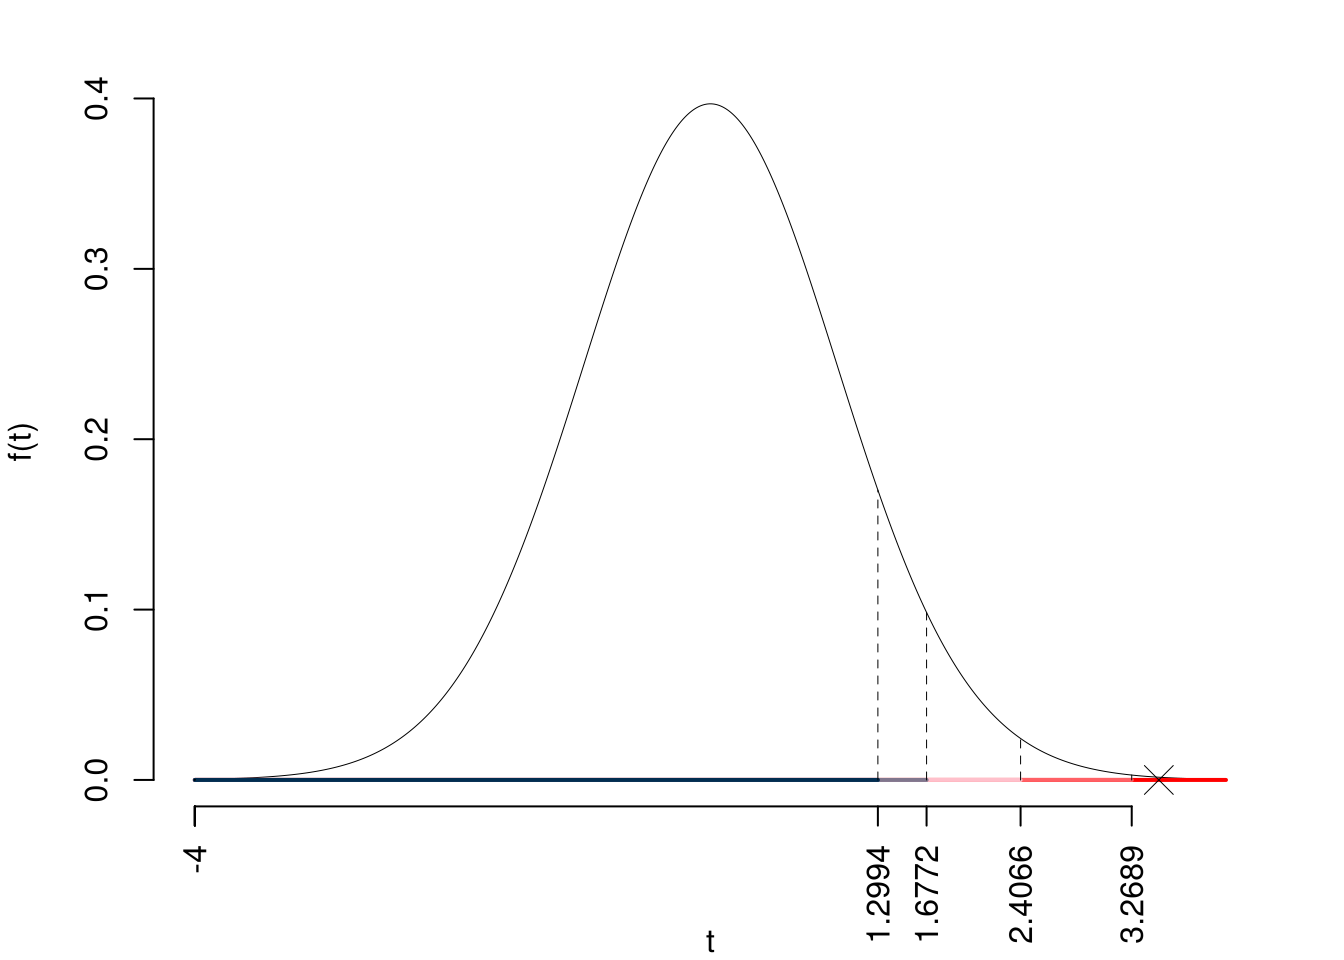
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(T_{50-2}>3.48)=0.000540 \]
Attenzione il calcolo del \(p_\text{value}\) con la \(T\) è puramente illustrativo e non può essere riprodotto senza una calcolatrice statistica adeguata.\[ 0 < p_\text{value}= 0.000540 \leq 0.001 \]
5.d (Punti 2/103 \(\rightarrow\) 0.6/31) Definire il diagramma dei residui
5.e (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione \(\hat\beta_1 <0\) che segno avrà \(r\)?
5.f (Punti 2/103 \(\rightarrow\) 0.6/31) Cosa significa dire che \(r^2\) è invariante ai cambiamenti di scala?
Significa che se \(V=a+bY\) e \(W=c+dX\) allora \(r^2_{VW}=r^2_{XY}\).
Prova di Statistica 2026/07/10-3
Esercizio 1
Su un campione di \(200\) blocchi d’ordine merce evasi da un grande polo logistico è stato rilevato il tempo di evasione dell’ordine (espresso in ore). Di seguito è riportata la distribuzione delle frequenze cumulate:
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(F_j\) |
|---|---|---|
| 0 | 6 | 0.1 |
| 6 | 8 | 0.3 |
| 8 | 9 | 0.7 |
| 9 | 11 | 0.9 |
| 11 | 17 | 1.0 |
1.a (Punti 13/103 \(\rightarrow\) 3.9/31) Disegnare l’istogramma di densità percentuale..
| \([\text{x}_j,\) | \(\text{x}_{j+1})\) | \(n_j\) | \(f_j\) | \(b_j\) | \(h_j\) |
|---|---|---|---|---|---|
| 0 | 6 | 20 | 0.1 | 6 | 1.67 |
| 6 | 8 | 40 | 0.2 | 2 | 10.00 |
| 8 | 9 | 80 | 0.4 | 1 | 40.00 |
| 9 | 11 | 40 | 0.2 | 2 | 10.00 |
| 11 | 17 | 20 | 0.1 | 6 | 1.67 |
| 200 | 1.0 | 17 |
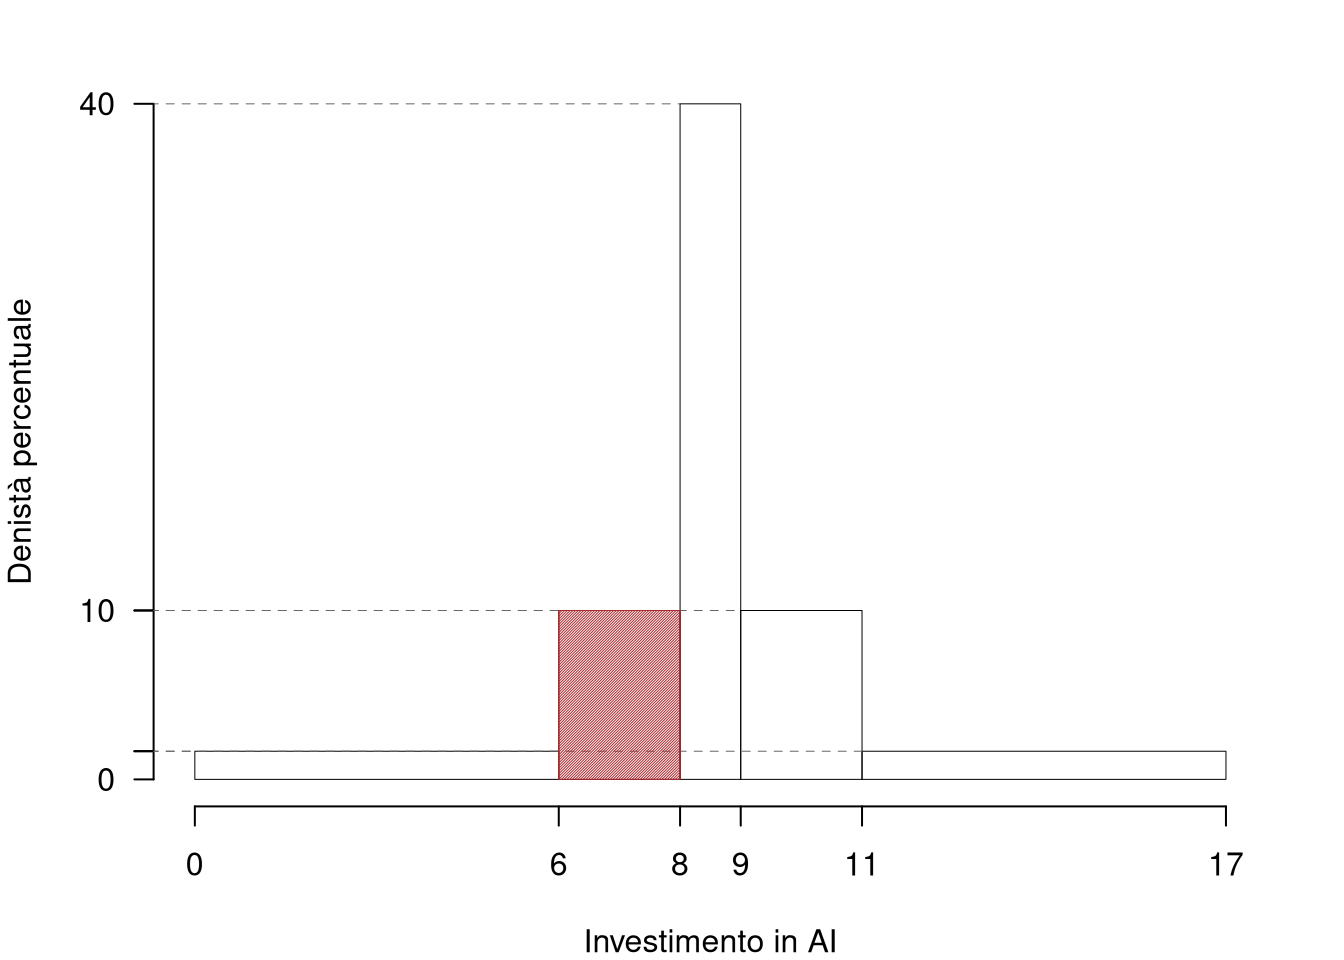
1.b (Punti 4/103 \(\rightarrow\) 1.2/31) Individuare il decimo, il 30-esimo, il 70-esimo e il 90-esimo percentile.
Direttamente leggendo le \(F_j\)
- Il 10% dei dati è inferiore a 6, il decimo percentile è 6
- Il 30% dei dati è inferiore a 8, il 30-esimo percentile è 8
- Il 70% dei dati è inferiore a 9, il 70-esimo percentile è 9
- Il 90% dei dati è inferiore a 11, il 90-esimo percentile è 11
In sintesi \(x_{0.1}=6, x_{0.3}=8, x_{0.7}=9, x_{0.9}=11\)
1.c (Punti 2/103 \(\rightarrow\) 0.6/31) Che relazione dobbiamo attenderci tra media, mediana e moda?
1.d (Punti 2/103 \(\rightarrow\) 0.6/31) Enunciare la proprietà di lineraità della media aritmetica.
Esercizio 2
Un’agenzia di servizi energetici contatta telefonicamente le piccole imprese per proporre un passaggio a contratti di fornitura da fonti rinnovabili. La probabilità che un singolo contatto si traduca nella firma effettiva di un contratto è pari a \(\pi=0.30\). Nel corso di una mattinata, un operatore contatta 5 imprese tra loro indipendenti. 2.a (Punti 13/103 \(\rightarrow\) 3.9/31) Posto \(X\) il numero dei contratti firmati in una mattinata, calcolare \(P(X\ge 1)\).
\[ X=X_1 + ... + X_5 \sim \operatorname{Binom}(5;0.30) \] \[\begin{eqnarray*} P( X \geq 1 ) &=& 1-P( X < 1 ) \\ &=& 1-\left( \binom{ 5 }{ 0 } 0.3 ^{ 0 }(1- 0.3 )^{ 5 - 0 } \right)\\ &=& 1-( 0.1681 )\\ &=& 1- 0.1681 \\ &=& 0.8319 \end{eqnarray*}\]
2.b (Punti 4/103 \(\rightarrow\) 1.2/31) L’operatore viene richiamato dopo la prma volta che non ottiene nessun contratto firmato in mattinata. Calcolare la probabilità che venga richiamato a fine delle quinta mattinata di lavoro.
\[ P(X\ge 1)= 0.8319 \qquad P(X=0)=1-0.8319\\ P(\text{richiamato alla quinta})=(0.8319)^4*(1-0.8319)=0.0805 \]
2.c (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(X_1\sim N(1,2)\) e \(X_2\sim N(1,2)\), \(X_1\) e \(X_2\) indipendenti. Posto \[ Y = \frac{X_1-X_2}{2} \] come si distribuisce \(Y^2\)?
\[ Y=\frac{X_1-X_2}{2} \sim N\left(1-1,\frac1{2^2}(2+2) \right)\sim N(0,1) \] e quindi \[ Y^2\sim \chi^2_1 \]
2.d (Punti 2/103 \(\rightarrow\) 0.6/31) Siano \(A\ne \emptyset\) e \(B\ne \emptyset\) due eventi tali che \(P(A|B)=0\). In che ralazione sono \(A\) e \(B\)?
Esercizio 3
3.a (Punti 13/103 \(\rightarrow\) 3.9/31) Un’urna contiene 1 pallina numerata con \(\fbox{0}\), 2 numerate con \(\fbox{1}\) e 1 numerata con \(\fbox{6}\). Si estrae 80 volte con reinserimento. Qual è la probabilità che la media degli 80 numeri estratti sia maggiore di 2.2?
\[\begin{eqnarray*} \mu &=& \frac 1{ 4 }( 0 + 1 + 1 + 6 )= 2 \\ \sigma^2 &=& \frac 1{ 4 }( 0 ^2+ 1 ^2+ 1 ^2+ 6 ^2 )-( 2 )^2= 5.5 \end{eqnarray*}\] Teorema del Limite Centrale (media VC qualunque)
Siano \(X_1\),…,\(X_n\), \(n=80\) VC IID, tc \(E(X_i)=\mu=2\) e \(V(X_i)=\sigma^2=5.5,\forall i\), posto: \[ \bar X=\frac{S_n}n =\frac{X_1 + ... + X_n}n \] allora:\[\begin{eqnarray*} \bar X & \mathop{\sim}\limits_{a}& N(\mu,\sigma^2/n) \\ &\sim & N\left(2,\frac{5.5}{80}\right) \\ &\sim & N(2,0.06875) \end{eqnarray*}\]\[\begin{eqnarray*} P( \bar X > 2.2 ) &=& P\left( \frac { \bar X - \mu }{ \sqrt{\sigma^2/n} } > \frac { 2.2 - 2 }{\sqrt{ 0.06875 }} \right) \\ &=& P\left( Z > 0.76 \right) \\ &=& 1-P(Z< 0.76 )\\ &=& 1-\Phi( 0.76 ) \\ &=& 0.2236 \end{eqnarray*}\]
Esercizio 4
4.a (Punti 3/103 \(\rightarrow\) 0.9/31) Siano \(x_1,...,x_n\) \(n\) osservazioni \(IID\), dal modello di Bernoulli \(X_i\sim\text{Ber}(\pi)\). Scrivere lo stimatore di massima verosimiglianza \(\hat\pi\) per \(\pi\) e mostrare la sua correttezza.
4.b (Punti 3/103 \(\rightarrow\) 0.9/31) Sia \(\hat\theta\) lo stimatore di massima verosimiglianza per \(\theta\), indicare la sua distribuzione asintotica.
4.c (Punti 3/103 \(\rightarrow\) 0.9/31) Definire un intervallo di confidenza al 95% per un generico parametro \(\theta\).
Un intervallo di confidenza al livello 95% per \(\theta\) è un intervallo costruito sui dati in modo tale che il 95% delle volte contenga il vero parametro \(\theta\). Ovvero è una coppia di statistiche \(L_1(X_1,...,X_n)<L_2(X_1,...,X_n)\) tali che \[ P([L_1(X_1,...,X_n),L_2(X_1,...,X_n)]\ni\theta)=0.95 \]
4.d (Punti 3/103 \(\rightarrow\) 0.9/31) Una moneta, che non sappiamo se è perfetta oppure no, viene lanciata 100 volte. Abbiamo osservato 34 volte testa su 100 lanci. Posto \(\pi\) la probabilità che la moneta mostri testa, si è testato \[ \begin{cases} H_0:\pi=\frac 12\\ H_1:\pi\ne\frac 12 \end{cases} \] ed è risultato \(p_\text{value}=0.1439\). Possiamo concludere che la moneta sia truccata? Perché?
Esercizio 5
In un’indagine sul grado di inclusività e presenza femminile nei ruoli di governance, sono state campionate 60 grandi aziende quotate con sede nel Nord Italia. L’indagine ha rilevato che 35 di queste aziende hanno inserito almeno una donna nel comitato di direzione (C-suite) o nel consiglio di amministrazione negli ultimi due anni.
5.a (Punti 3/103 \(\rightarrow\) 0.9/31) Costruire un intervallo di confidenza al 95% per la proporzione di grandi aziende del Nord Italia che hanno una rappresentanza femminile nei ruoli di vertice.
\(1-\alpha =0.95\) e quindi \(\alpha=0.05\rightarrow \alpha/2=0.025\)
\[ \hat\pi = \frac{S_n}n = \frac{ 35 }{ 60 }= 0.5833 \]
\[\begin{eqnarray*} Idc: & & \hat\pi \pm z_{\alpha/2} \times \sqrt{\frac{\hat\pi(1-\hat\pi)}{n}} \\ & & 0.5833 \pm 1.96 \times \sqrt{\frac{ 0.5833 (1- 0.5833 )}{ 60 }} \\ & & 0.5833 \pm 1.96 \times 0.06365 \\ & & [ 0.4586 , 0.7081 ] \end{eqnarray*}\]
5.b (Punti 10/103 \(\rightarrow\) 3/31) Un rapporto analogo condotto a livello europeo (Eurostat) rileva che la proporzione di grandi imprese con una governance inclusiva è pari a 0.55. Testare l’ipotesi che la proporzione delle grandi aziende del Nord Italia sia uguale alla media europea contro l’alternativa che sia maggiore. Risolvere con il \(p_{\text{value}}\) e confrontarlo per \(\alpha = 0.1, \ 0.05, \ 0.01, \ 0.001\).
Test \(Z\) per una proporzione
La stima \[\hat\pi=\frac { 35 } { 60 }= 0.5833 \]
\(\fbox{A}\) FORMULAZIONE DELLE IPOTESI
\[\begin{cases} H_0: \pi = \pi_0=0.55 \\ H_1: \pi > \pi_0=0.55 \end{cases}\]
\(\fbox{B}\) SCELTA E CALCOLO STATISTICA-TEST, \(Z\) Test Binomiale per \(n\) grande: \(\Rightarrow\) z-Test.
\[\begin{eqnarray*} \frac{\hat\pi - \pi_{0}} {\sqrt {\pi_0(1-\pi_0)/\,n}}&\sim&N(0,1)\\ z_{\text{obs}} &=& \frac{ ( 0.5833 - 0.55 )} {\sqrt{ 0.55 (1- 0.55 )/ 60 }} = 0.519 \,. \end{eqnarray*}\]
\(\fbox{C}\) CONCLUSIONE
Il \(p_{\text{value}}\) è
\[ p_{\text{value}} = P(Z>0.52)=0.301881 \]
\[
0.1 < p_\text{value}= 0.301881 \leq 1
\]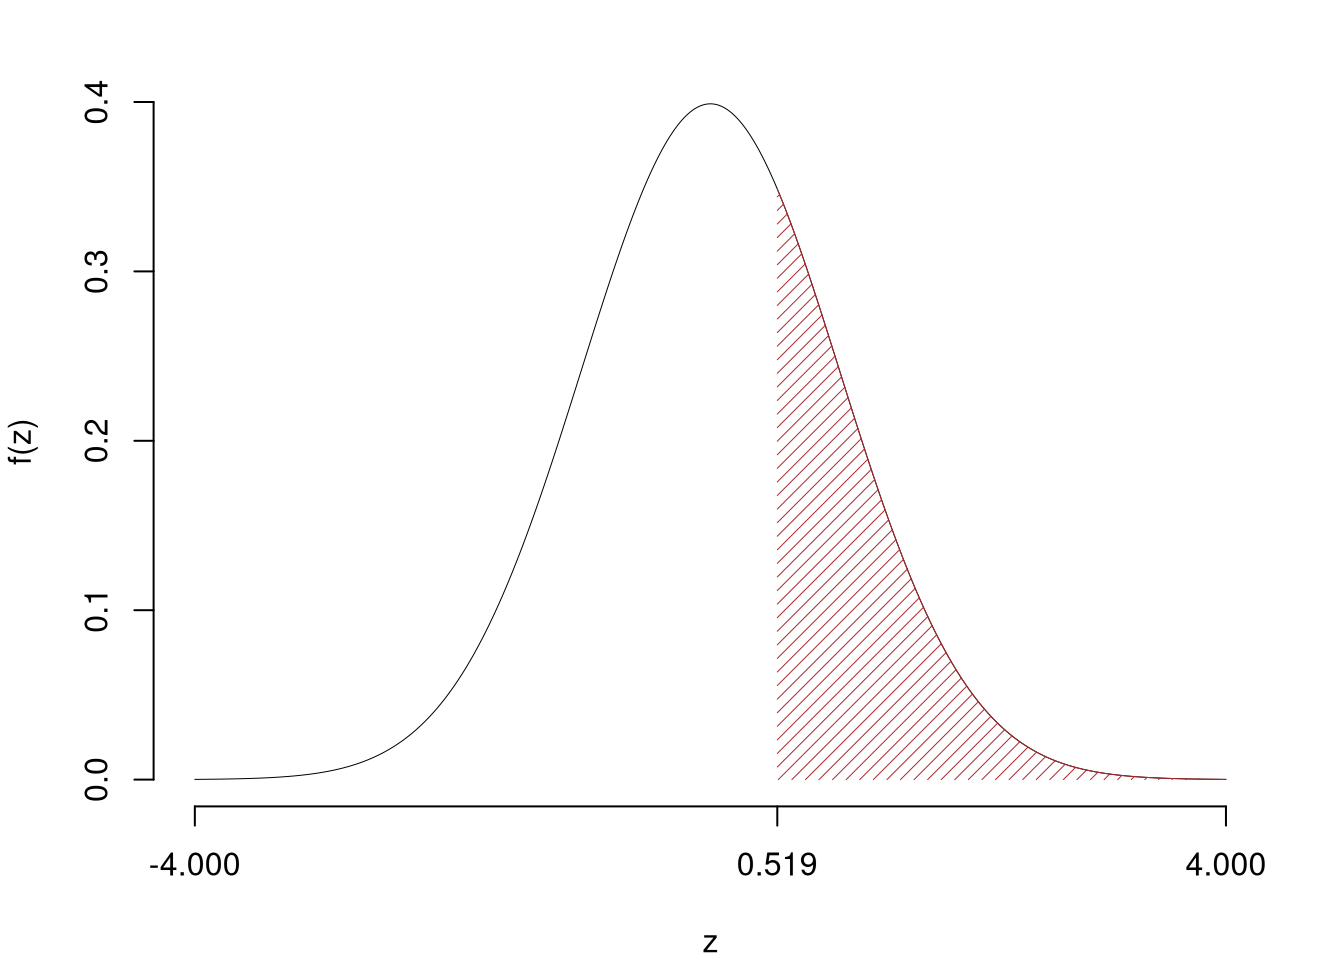
Non rifiuto \(H_0\) a nessun livello di significatività,
\(p_\text{value}>0.1\), non significativo
Esercizio 6
In uno studio condotto su un campione di \(n = 50\) imprese manifatturiere ad alta tecnologia, sono state analizzate la percentuale del fatturato investita annualmente in Ricerca e Sviluppo (\(X\)) e la quota di mercato della produzione esportata all’estero (espressa in percentuale, \(Y\)).
Si sono osservate le seguenti statistiche: \[\begin{align*} \sum_{i=1}^n x_i &= 503.4, &\sum_{i=1}^n x_i^2 &= 5235.54 & \\ \sum_{i=1}^n y_i &= 115.36, &\sum_{i=1}^n y_i^2 &= 268.18 &\sum_{i=1}^n x_iy_i &= 1177.95. \end{align*}\]
6.a (Punti 13/103 \(\rightarrow\) 3.9/31) Per l’azienda \(A\) si è osservato \(x_A=10.1\) e \(y_A=2.45\), stimare il modello di regressione dove \(Y\) viene spiegata da \(X\) e calcolare il residuo per l’azienda \(A\).
\[\begin{eqnarray*} \bar x &=&\frac 1 n\sum_{i=1}^n x_i = \frac {1}{ 50 } 503.4 = 10.07 \\ \bar y &=&\frac 1 n\sum_{i=1}^n y_i = \frac {1}{ 50 } 115.36 = 2.307 \\ \hat\sigma_X^2&=&\frac 1 n\sum_{i=1}^n x_i^2-\bar x^2=\frac {1}{ 50 } 5236 - 10.068 ^2= 3.346 \\ \hat\sigma_Y^2&=&\frac 1 n\sum_{i=1}^n y_i^2-\bar y^2=\frac {1}{ 50 } 268.2 - 2.3072 ^2= 0.04043 \\ \text{cov}(X,Y)&=&\frac 1 n\sum_{i=1}^n x_i~y_i-\bar x\bar y=\frac {1}{ 50 } 1178 - 10.068 \cdot 2.3072 = 0.3302 \\ \hat\beta_1 &=& \frac{\text{cov}(X,Y)}{\hat\sigma_X^2} \\ &=& \frac{ 0.3302 }{ 3.346 } = 0.09867 \\ \hat\beta_0 &=& \bar y - \hat\beta_1 \bar x\\ &=& 2.307 - 0.0987 \times 10.068 = 1.314 \end{eqnarray*}\]\[\begin{eqnarray*} \hat y_i &=&\hat\beta_0+\hat\beta_1 x_i=\\ &=& 1.314 + 0.0987 \times 10.1 = 2.31 \\ \hat \varepsilon_i &=& y_i-\hat y_i\\ &=& 2.449 - 2.3104 = 0.139 \end{eqnarray*}\]
6.b (Punti 4/103 \(\rightarrow\) 1.2/31) Scomporre la varianza di \(Y\).
\[\begin{eqnarray*} TSS &=& n\hat\sigma^2_Y\\ &=& 50 \times 0.04043 \\ &=& 2.021 \\ ESS &=& R^2\cdot TSS\\ &=& 0.8058 \cdot 2.021 \\ &=& 1.629 \\ RSS &=& (1-R^2)\cdot TSS\\ &=& (1- 0.8058 )\cdot 2.021 \\ &=& 0.3926 \\ TSS &=& ESS+RSS \\ 2.021 &=& 1.629 + 0.3926 \end{eqnarray*}\]
6.c (Punti 2/103 \(\rightarrow\) 0.6/31) Definire gli outliers e i punti di leva.
6.d (Punti 2/103 \(\rightarrow\) 0.6/31) Se in un modello di regressione \(\hat\beta_1 >0\) in che relazione sono \(x\) ed \(y\)?
6.e (Punti 2/103 \(\rightarrow\) 0.6/31) Cosa significa quando \(r^2=0\)?